Zum Hauptinhalt springen

Schlagwort: C

Conversational Search erklärt: Die dialogorientierte Suche mit Folgefragen in Google KI Mode, ChatGPT und Perplexity, taismo SEO-Wiki

Conversational Search

Was ist Conversational Search?

Conversational Search ist eine Form der Informationssuche, bei der Nutzer ihre Anfrage in natürlicher Sprache als Frage formulieren und das Suchsystem den Zusammenhang über mehrere Gesprächsrunden behält. Statt einer Liste von Links liefert Conversational Search eine formulierte Antwort und beantwortet Folgefragen, ohne dass die Anfrage neu eingegeben werden muss. Bekannte Beispiele sind der KI Mode der Google-Suche, die Suche in ChatGPT, Perplexity und Microsoft Copilot.
Conversational Search erklärt: Die dialogorientierte Suche mit Folgefragen in Google KI Mode, ChatGPT und Perplexity, taismo SEO-Wiki

Kurzprofil des Begriffs

Merkmal Angabe
Wortart Substantiv, englischer Fachbegriff, meist mit dem Artikel „die“ gebraucht
Aussprache ˌkɑːnvərˈseɪʃənəl sɜːrtʃ
Deutsche Entsprechung dialogorientierte Suche, Konversationssuche
Gegenbegriff Keyword-Suche mit Stichworten und Ergebnisliste
Bekannte Systeme Google KI Mode, ChatGPT-Suche, Perplexity, Microsoft Copilot, Sprachassistenten
Verwandte Begriffe KI-Suche, Query Fan-Out, Retrieval Augmented Generation, Voice Search, Suchintention

Wie funktioniert Conversational Search?

Conversational Search arbeitet in 4 Schritten: Das System versteht die Frage, behält den Gesprächsverlauf, stellt eine Antwort aus mehreren Quellen zusammen und lädt zur nächsten Frage ein.

  1. Frage verstehen: Das System liest die Eingabe als ganzen Satz und erkennt die Absicht dahinter, also die Suchintention. Die Grundlage dafür ist Natural Language Processing.
  2. Kontext behalten: Jede neue Frage wird im Licht der vorherigen gelesen. Fragt jemand nach einer Bäckerei und danach „Hat die auch sonntags offen?“, weiß das System, dass mit „die“ die zuvor genannte Bäckerei gemeint ist.
  3. Antwort zusammenstellen: Das System zerlegt die Frage in mehrere Teilsuchen, ein Verfahren namens Query Fan-Out. Die gefundenen Textstellen fasst ein Sprachmodell zu einer Antwort zusammen und verlinkt die Quellen. Diese Kopplung von Suche und Sprachmodell heißt Retrieval Augmented Generation.
  4. Weiterführen: Am Ende schlägt das System oft passende Folgefragen vor oder stellt selbst eine Rückfrage, wenn die Anfrage mehrdeutig war.

Der entscheidende Unterschied liegt im zweiten Schritt. Eine klassische Suchmaschine behandelt jede Eingabe als neue, unabhängige Anfrage. Conversational Search behandelt die Eingaben als ein zusammenhängendes Gespräch, in dem jede Antwort auf dem bisherigen Verlauf aufbaut.

Keyword-Suche oder Conversational SearchLinks stehen drei getrennte Stichwortsuchen untereinander: bäckerei schwabing, bäckerei schwabing sonntag geöffnet und bäckerei schwabing glutenfrei. Jede beginnt von vorn und liefert eine eigene Ergebnisliste. Rechts steht dasselbe Anliegen als ein Gespräch mit drei Fragen: Welche Bäckerei in Schwabing hat sonntags offen, Hat eine davon glutenfreies Brot und Wie komme ich mit der U-Bahn hin. Eine orange Linie verbindet die Fragen und zeigt, dass der Kontext erhalten bleibt.Dasselbe Anliegen, zwei Arten zu suchenKeyword-Suche3 getrennte Anfragenbäckerei schwabing↺bäckerei schwabing sonntag geöffnet↺bäckerei schwabing glutenfrei↺jede Suche beginnt von vornConversational Search1 GesprächWelche Bäckerei in Schwabing hat sonntags offen?Hat eine davon glutenfreies Brot?Wie komme ich mit der U-Bahn hin?Kontext bleibt erhaltenAbb. 1 · taismo
Abb. 1: Dasselbe Anliegen als drei getrennte Stichwortsuchen und als ein Gespräch, in dem der Kontext erhalten bleibt.

Wie unterscheidet sich Conversational Search von der klassischen Keyword-Suche?

Conversational Search unterscheidet sich von der Keyword-Suche in Eingabe, Kontext, Ergebnis und Erfolgsmaß. Die folgende Tabelle stellt beide Formen gegenüber:

Merkmal Keyword-Suche Conversational Search
Eingabe Wenige Stichworte, etwa „bäckerei schwabing“ Ganze Sätze und Fragen in Alltagssprache
Kontext Jede Suche beginnt neu Der Gesprächsverlauf bleibt erhalten
Ergebnis Liste mit Links und Snippets Formulierte Antwort mit Quellenlinks
Rückfragen Nicht vorgesehen Folgefragen und Rückfragen des Systems
Rolle des Nutzers Wählt selbst aus den Treffern aus Lässt das System auswählen und zusammenfassen
Erfolg für Websites Platz in der Ergebnisliste und Klick Nennung oder Verlinkung als Quelle in der Antwort

Beide Formen bestehen nebeneinander. Viele Nutzer stellen eine Frage im Dialog und wechseln für eine konkrete Website oder ein Produkt zurück in die klassische Suche. Wer nur eine der beiden Formen bedient, verliert einen Teil der Nachfrage.

Seit wann gibt es Conversational Search?

Die Idee der dialogorientierten Suche ist älter als ChatGPT und hat sich über mehr als zehn Jahre in 3 Stufen entwickelt.

  1. Sprachassistenten (ab 2011): Apple stellte 2011 Siri vor, Google folgte 2012 mit Google Now. Die Assistenten verstanden gesprochene Fragen, konnten aber kaum mehrere Runden führen.
  2. Semantische Suche (ab 2013): Google bezeichnete 2013 die gesprochene Suche in Chrome selbst als Conversational Search. Im selben Jahr stellte das Hummingbird-Update die Bedeutung ganzer Fragen in den Mittelpunkt der semantischen Suche.
  3. KI-Suche mit Sprachmodellen (ab 2022): Perplexity startete im Dezember 2022, Microsoft brachte im Februar 2023 Bing Chat heraus, das heute Copilot heißt. OpenAI ergänzte ChatGPT im Oktober 2024 um eine eigene Websuche. Google startete den KI Mode 2025 in den USA, seit dem 8. Oktober 2025 ist er auch in Deutschland verfügbar.

Parallel dazu hat die Forschung das Feld systematisch untersucht. Das Text Retrieval Conference Programm des US-amerikanischen NIST führte von 2019 bis 2022 einen eigenen Wettbewerb für dialogorientierte Suchsysteme durch, den Conversational Assistance Track.

Welche Systeme bieten Conversational Search?

Im deutschsprachigen Raum prägen 5 Systeme die Conversational Search.

System Anbieter Besonderheit
KI Mode Google Eigener Dialogmodus der Google-Suche, in Deutschland seit Oktober 2025
ChatGPT-Suche OpenAI Websuche innerhalb von ChatGPT mit Quellenlinks
Perplexity Perplexity AI Antwortmaschine, die jede Aussage mit nummerierten Quellen belegt
Copilot Microsoft Dialogsuche auf Basis von Bing, eingebunden in Windows und Office
Sprachassistenten Apple, Amazon, Google Siri, Alexa und Gemini beantworten gesprochene Fragen im Dialog

Der KI Mode ist für Websites besonders wichtig, weil er direkt im Suchfeld von Google steckt. Was der Modus für Klicks und Sichtbarkeit bedeutet, vertieft der Ratgeber zum Google AI Mode. Einen Überblick über alle Systeme, die Antworten statt Trefferlisten liefern, gibt der Beitrag zur KI-Suche.

Was bedeutet Conversational Search für SEO?

Conversational Search verschiebt das Ziel von SEO: Eine Seite muss nicht nur gefunden werden, sondern als Quelle in eine Antwort passen. Daraus ergeben sich 5 Aufgaben für Inhalte:

  1. Die nächste Frage mitdenken: Ein Gespräch läuft selten bei der ersten Frage aus. Wer nach einer Leistung fragt, fragt danach nach Kosten, Dauer und Ablauf. Eine Seite, die diese Folgefragen beantwortet, bleibt über mehrere Runden als Quelle relevant.
  2. Die Antwort an den Anfang stellen: Der erste Satz eines Abschnitts sollte die Frage seiner Überschrift direkt beantworten. So kann das System die Aussage sauber herauslösen.
  3. Abschnitte eigenständig formulieren: Beim Query Fan-Out landet oft nur ein einzelner Abschnitt in der Antwort. Er sollte ohne den Rest der Seite verständlich sein.
  4. In Fragen statt in Stichworten recherchieren: Die Google Search Console zeigt in den Suchanfragen zunehmend ganze Sätze. Ein Filter auf Fragewörter wie „wie“, „welche“ oder „was kostet“ macht sichtbar, welche Gesprächsfragen Nutzer wirklich stellen.
  5. Sichtbarkeit in Antworten messen: Rankings allein zeigen nicht, ob eine Marke in Antworten vorkommt. Aussagekräftiger ist der Share of Voice in KI-Antworten, gemessen über feste Fragen und mehrere Systeme.

Die gesprochene Variante der Suche verlangt dasselbe, nur ohne Bildschirm. Was dort zusätzlich zählt, beschreibt der Beitrag zu Voice SEO. Wie sich Inhalte gezielt auf KI-Antworten ausrichten lassen, zeigt unsere Seite zu GEO und KI-Sichtbarkeit.

Häufige Fragen zu Conversational Search

Ist Conversational Search dasselbe wie Voice Search?
Nein. Voice Search beschreibt den Eingabeweg per Stimme, Conversational Search den Dialog über mehrere Runden. Beide überschneiden sich oft, eine Conversational Search funktioniert aber genauso per Texteingabe.

Was ist der Unterschied zwischen Conversational Search und einem Chatbot?
Ein klassischer Chatbot antwortet aus einem festen Wissensbestand oder aus vorgegebenen Antworten. Conversational Search durchsucht für jede Frage einen Index aus Webseiten oder Dokumenten und nennt die Quellen, aus denen die Antwort stammt.

Ersetzt Conversational Search die klassische Google-Suche?
Nein. Die klassische Ergebnisliste besteht weiter, Conversational Search kommt als zusätzlicher Weg hinzu. Google bietet den KI Mode als eigenen Bereich neben den normalen Suchergebnissen an.

Common Crawl erklärt: Das offene Webarchiv und der Crawler CCBot als Datenquelle für Sprachmodelle, taismo SEO-Wiki

Common Crawl

Was ist Common Crawl?

Common Crawl ist ein frei zugängliches Archiv von Webseiten, das die gemeinnützige Common Crawl Foundation seit 2008 mit ihrem Crawler CCBot aufbaut und etwa einmal im Monat um einen neuen Crawl erweitert. Jeder Crawl enthält Rohdaten, Metadaten und extrahierten Text von rund zwei Milliarden Seiten und steht kostenlos zum Download bereit. Common Crawl ist damit eine der wichtigsten Quellen, aus denen große Sprachmodelle ihr Wissen über das Web beziehen.

Common Crawl erklärt: Das offene Webarchiv und der Crawler CCBot als Datenquelle für Sprachmodelle, taismo SEO-Wiki

Kurzprofil des Begriffs

Merkmal Angabe
Wortart Eigenname (englisch), ohne Artikel gebraucht
Aussprache ˈkɒmən ˈkrɔːl
Betreiber Common Crawl Foundation, gemeinnützige Organisation nach US-Recht, gegründet 2007
Crawler CCBot, User-Agent CCBot/2.0 (https://commoncrawl.org/faq/)
Aktueller Crawl CC-MAIN-2026-39: 2,17 Milliarden Seiten von 40,4 Millionen Hosts, erfasst vom 4. bis 17. September 2026
Dateiformate WARC (Rohdaten), WAT (Metadaten und Links), WET (reiner Text)
Verwandte Begriffe CCBot, KI-Crawler, Trainingsdaten, robots.txt, Web Graph

Wie funktioniert Common Crawl?

Common Crawl arbeitet in 4 Schritten: Der Crawler wählt Kandidaten aus, ruft die Seiten ab, archiviert sie in 3 Dateiformaten und veröffentlicht den fertigen Crawl als offenen Datensatz. Ein Crawl läuft rund zwei Wochen; der September-Crawl 2026 lief vom 4. bis 17. September.

  1. Kandidaten auswählen: Common Crawl berechnet aus seinem eigenen Linkgraphen für jede Domain die Harmonic Centrality. Der Wert misst, wie nah eine Domain über Links an allen anderen Domains liegt. Gut verlinkte Domains bekommen mehr Crawl-Budget und landen mit mehr Seiten im Archiv.
  2. Seiten abrufen: Der Crawler CCBot basiert auf Apache Nutch. Er liest zuerst die robots.txt einer Domain, folgt bis zu vier Weiterleitungen und nutzt die dort angegebene Sitemap. CCBot führt kein JavaScript aus und setzt keine Cookies.
  3. Archivieren: Jede abgerufene Seite landet als WARC-Datei mit vollständiger HTTP-Antwort, als WAT-Datei mit Metadaten und Links und als WET-Datei mit dem reinen Text. Dazu archiviert Common Crawl die robots.txt-Dateien und die Fehlerantworten jedes Crawls.
  4. Veröffentlichen: Der fertige Crawl liegt im öffentlichen Datenbestand von Amazon Web Services und unter data.commoncrawl.org. Der Zugriff ist kostenlos, ein URL-Index macht einzelne Seiten auffindbar.

Common Crawl erfasst eine Stichprobe des Webs. Die Foundation beschreibt ihren Datensatz selbst als zufällig ausgewählten Ausschnitt jeder Website. Für Website-Betreiber heißt das: Welche Seiten im Archiv landen, wechselt von Crawl zu Crawl.

Inhalte, die erst per JavaScript nachgeladen werden, fehlen im Archiv. Das ist dieselbe Hürde, die JavaScript-SEO für Suchmaschinen beschreibt; bei CCBot gibt es keinen Renderdienst, der sie später auflöst.

Der Weg einer Webseite über Common Crawl in ein SprachmodellFünf Kästen in einer Reihe zeigen den Datenweg: Websites, der Crawler CCBot, das Common-Crawl-Archiv mit den Formaten WARC, WAT und WET, gefilterte Datensätze wie C4, Pile-CC und FineWeb und schließlich das Training eines Sprachmodells. Der Kasten CCBot ist orange hervorgehoben, weil nur an dieser Stelle die robots.txt eines Website-Betreibers wirkt, und zwar ausschließlich auf künftige Crawls.Von der Website ins SprachmodellWebsites40,4 Mio. Hostsim Crawl 2026-39CCBotprüft robots.txt,kein JavaScriptArchivWARC · WAT · WET2,17 Mrd. SeitenFilterdatensätzeC4 · Pile-CCFineWebSprachmodellTraining aufdem SnapshotDeine robots.txt wirkt nur beim Abruf durch CCBot.Frühere Crawls und die daraus gebauten Datensätze bleiben bestehen.Abb. 1 · taismo
Abb. 1: Der Weg einer Webseite über Common Crawl in ein Sprachmodell. Die robots.txt wirkt nur beim Abruf durch CCBot und nur auf künftige Crawls.

Welche Sprachmodelle nutzen Common Crawl?

Mindestens 30 von 47 großen Sprachmodellen, die zwischen 2019 und Oktober 2023 erschienen sind, wurden mit einer gefilterten Fassung von Common Crawl trainiert, das sind 64 Prozent. Das zeigt die Studie „Training Data for the Price of a Sandwich“ der Mozilla Foundation vom Februar 2024. Bei GPT-3 von OpenAI stammten mehr als 80 Prozent der Trainings-Tokens aus Common Crawl.

Ein Large Language Model verarbeitet Common Crawl in der Regel über eine aufbereitete Fassung. Die Rohdaten enthalten Menüs, Cookie-Hinweise, Dubletten und Spam; KI-Entwickler greifen deshalb auf gefilterte Datensätze zurück. Die 3 bekanntesten sind:

  • C4 (Colossal Clean Crawled Corpus): Google hat C4 für das Sprachmodell T5 gebaut. Der Datensatz gehört zu den meistgenutzten Filterfassungen.
  • Pile-CC: Pile-CC ist der Common-Crawl-Anteil im Datensatz „The Pile“ von EleutherAI.
  • FineWeb: Hugging Face hat FineWeb aus zahlreichen Common-Crawl-Snapshots gefiltert und frei veröffentlicht.

Meta hat für die erste Llama-Generation gleich zwei Filterfassungen kombiniert. Die Filter entfernen vor allem Pornografie, Textbausteine und Dubletten. Die Auswahl der Seiten, die Common Crawl vorher getroffen hat, übernehmen sie unverändert: Inhalte aus englischsprachigen und gut verlinkten Domains sind überproportional vertreten.

Warum leben alte Inhalte über Common Crawl in KI-Antworten weiter?

Ein Sprachmodell kennt eine Website in dem Stand, den der Crawl zum Zeitpunkt des Trainings erfasst hat. Aktualisierst du eine Seite heute, ändert das nichts am Wissen eines Modells, das mit einem Crawl von 2024 trainiert wurde. Die alte Fassung steht im Archiv, in den daraus gebauten Filterdatensätzen und in jedem Modell, das damit trainiert wurde.

Drei Folgen sind für Website-Betreiber relevant:

  1. Veraltete Angaben bleiben abrufbar: Alte Preise, frühere Leistungen oder ein überholter Firmenname stehen in früheren Crawls weiter zur Verfügung und können in Modellantworten auftauchen.
  2. Neues braucht einen Trainingszyklus: Eine neue Seite erreicht das Modellwissen erst, wenn ein späterer Crawl sie erfasst und ein Anbieter damit neu trainiert.
  3. Aktualität kommt über die Live-Suche: Viele KI-Systeme gleichen ihr Trainingswissen per Retrieval Augmented Generation mit aktuellen Suchergebnissen ab. Dort zählt der heutige Stand deiner Seite.

Für eine Marke heißt das: Konsistente Angaben über Jahre zahlen sich doppelt aus. Wer Name, Leistung und Kernaussagen stabil hält, prägt das Trainingswissen und die Live-Antwort mit derselben Information. So wird das Unternehmen für Modelle zu einer klar erkennbaren Entität.

Wie prüfst du, ob deine Website in Common Crawl enthalten ist?

Ob deine Website in Common Crawl steht, zeigt der öffentliche URL-Index unter index.commoncrawl.org. Eine einzige Abfrage je Crawl liefert alle erfassten Adressen deiner Domain mit Statuscode und Dateityp:

https://index.commoncrawl.org/CC-MAIN-2026-39-index?url=deine-domain.de/*&output=json

Die Kennung CC-MAIN-2026-39 steht für den September-Crawl 2026; die Liste aller Crawls liefert index.commoncrawl.org/collinfo.json. Der Index ist stark gedrosselt. Stell deine Abfragen nacheinander und mit Pause, sonst sperrt der Server deine IP-Adresse für 24 Stunden.

Für taismo.de haben wir das am 24. September 2026 nachgesehen. Der August-Crawl CC-MAIN-2026-34 enthält 213 abrufbare Seiten der Domain, der September-Crawl CC-MAIN-2026-39 nur 69. Beide Crawls teilen sich gerade 7 URLs, bei rund 450 Adressen in der Sitemap. Die Messung bestätigt das Stichprobenprinzip: Jeder Crawl zeigt einen anderen Ausschnitt derselben Website.

Wie steuerst du CCBot über die robots.txt?

CCBot hält sich an die robots.txt und reagiert auf den User-Agent CCBot. Mit zwei Zeilen sperrst du den Crawler für die ganze Website:

User-agent: CCBot
Disallow: /

Soll CCBot weiter crawlen, aber langsamer, genügt ein Crawl-delay in Sekunden. CCBot beachtet diese Angabe ausdrücklich, Googlebot ignoriert sie:

User-agent: CCBot
Crawl-delay: 2

Vier Punkte gehören zur Steuerung dazu:

  • Die Sperre wirkt nach vorn: Sie verhindert künftige Abrufe. Frühere Crawls mit deinen Seiten bleiben veröffentlicht, ebenso die daraus gebauten Datensätze.
  • Falsche CCBots gibt es: Common Crawl warnt selbst vor Crawlern, die sich als CCBot ausgeben. Echte Abrufe kommen aus festen IP-Bereichen, die unter index.commoncrawl.org/ccbot.json stehen, und lösen per Reverse DNS auf crawl.commoncrawl.org auf.
  • Die Sitemap hilft beim Zulassen: CCBot liest jede Sitemap, die in der robots.txt angegeben ist. Eine gepflegte Sitemap erhöht die Chance, dass die wichtigen Seiten erfasst werden.
  • Google bleibt unberührt: Eine CCBot-Sperre betrifft ausschließlich Common Crawl. Googlebot und die Rankings in der Google-Suche ändern sich dadurch nicht.

CCBot ist einer von vielen Bots, die Inhalte für KI-Systeme sammeln. Wie sich die anderen unterscheiden und welche davon Trainingsdaten und welche Live-Antworten bedienen, erklärt der Beitrag zu KI-Crawlern.

Solltest du CCBot sperren oder zulassen?

Für Unternehmen, die in KI-Antworten genannt werden wollen, ist das Zulassen von CCBot in den meisten Fällen die bessere Wahl. Eine Sperre nimmt die Website aus den künftigen Trainingsdaten vieler offener und kommerzieller Modelle. Sprachmodelle lernen die Marke, ihre Leistungen und ihre Fachbegriffe dann nur noch aus fremden Quellen kennen.

Ziel Empfehlung Begründung
Sichtbar in KI-Antworten werden CCBot zulassen Die eigenen Inhalte fließen in künftige Trainingsdaten ein und prägen, was Modelle über die Marke wissen
Bezahlte oder exklusive Inhalte schützen CCBot sperren Das Archiv ist frei zugänglich, jeder kann die Texte herunterladen und weiterverwenden
Serverlast begrenzen Crawl-delay setzen CCBot bleibt aktiv und ruft Seiten in größerem Abstand ab

Große Verlage wie die New York Times sperren CCBot bereits für ihre Inhalte. Für einen Mittelständler mit erklärungsbedürftiger Leistung wirkt dieselbe Sperre anders: Sie macht das Unternehmen für Modelle unsichtbarer, ohne ein Geschäftsmodell zu schützen. taismo.de lässt CCBot deshalb zu.

Wer zugelassen ist, kann seine Präsenz im Archiv beeinflussen. Da Common Crawl nach Harmonic Centrality priorisiert, erhöhen Backlinks von gut vernetzten Websites die Chance, dass mehr Seiten einer Domain erfasst werden. Eine klare Einstiegskarte für Sprachmodelle ergänzt die llms.txt. Wie diese Hebel zusammenwirken, beschreibt unsere Seite zu GEO und KI-Sichtbarkeit.

Häufige Fragen zu Common Crawl

Ist Common Crawl dasselbe wie das Internet Archive?
Common Crawl und das Internet Archive sind zwei getrennte gemeinnützige Projekte. Die Wayback Machine des Internet Archive zeigt Menschen frühere Fassungen einzelner Seiten im Browser, Common Crawl liefert Massendaten für Forschung und Datenanalyse.

Kostet die Nutzung von Common Crawl etwas?
Die Daten von Common Crawl sind kostenlos. Die Foundation stellt sie über den öffentlichen Datenbestand von Amazon Web Services und über data.commoncrawl.org bereit; Kosten entstehen höchstens für eigene Rechen- und Speicherkapazität.

Schadet eine CCBot-Sperre meinem Google-Ranking?
Eine CCBot-Sperre hat keinen Einfluss auf das Google-Ranking. Google crawlt mit dem eigenen Googlebot und nutzt Common Crawl nicht als Quelle für die Suche.

Cloaking: Suchmaschinen erhalten andere Inhalte als menschliche Besucher, erklärt im taismo SEO-Wiki

Cloaking

Was ist Cloaking?

Cloaking ist eine Spam-Technik, bei der ein Webserver Suchmaschinen-Crawlern andere Inhalte ausliefert als menschlichen Besuchern, um Rankings zu manipulieren. Google definiert Cloaking in seinen Spam-Richtlinien als Verfahren, „bei dem für menschliche Nutzer andere Inhalte als für Suchmaschinen zur Verfügung gestellt werden“, und ahndet den Verstoß mit Rankingverlust bis hin zum Ausschluss aus dem Index. Cloaking zählt zu den Black-Hat-SEO-Techniken.

Cloaking: Suchmaschinen erhalten andere Inhalte als menschliche Besucher, erklärt im taismo SEO-Wiki

Wie funktioniert Cloaking technisch?

Der Webserver entscheidet bei jedem Aufruf, welche Version der Seite er ausliefert. Dafür prüft er zwei Merkmale des Besuchers: den User-Agent (meldet sich der Zugriff als „Googlebot“?) und die IP-Adresse (stammt der Zugriff aus den bekannten Adressbereichen der Suchmaschinen-Crawler?). Erkennt der Server einen Crawler, liefert er eine eigens präparierte, keyword-optimierte Version aus; echte Besucher sehen einen anderen Inhalt.

Googles Spam-Richtlinien nennen als Beispiel eine Seite, die dem Crawler Reise-Inhalte zeigt, während Nutzer Angebote für Arzneimittel sehen. Auch das Einblenden von Text oder Keywords ausschließlich für Suchmaschinen ist Cloaking.

Funktionsweise von CloakingEin Webserver erkennt den Besucher und liefert dem Suchmaschinen-Crawler Version A mit optimiertem Text, dem menschlichen Nutzer dagegen Version B mit anderem Inhalt.Webserverprüft User-Agent + IPCrawler sieht Version Akeyword-optimierter TextNutzer sieht Version Banderer, oft irreführender InhaltAbb. 1 · taismo
Abb. 1: Beim Cloaking liefert der Server dem Crawler eine andere Version der Seite aus als dem menschlichen Besucher.

Warum bestraft Google Cloaking?

Cloaking täuscht Nutzer: Sie klicken auf ein Suchergebnis und landen auf einem Inhalt, den Google so nie bewertet hat. Deshalb führt Google Cloaking ausdrücklich in seinen Spam-Richtlinien und reagiert auf zwei Wegen: Algorithmisch erkennen Spam-Systeme wie SpamBrain die Täuschung und werten die Seite ab. Manuell kann das Webspam-Team eine Maßnahme verhängen; die betroffene Website verliert dann Rankings oder fliegt komplett aus dem Index. Über eine manuelle Maßnahme informiert Google in der Search Console, die Aufhebung erfordert einen Antrag auf erneute Überprüfung. Wie andere Black-Hat-SEO-Techniken tauscht Cloaking also einen kurzfristigen Effekt gegen das Risiko, die gesamte Sichtbarkeit zu verlieren.

Was gilt nicht als Cloaking?

Google nennt selbst 3 Fälle, die kein Cloaking sind:

  • Paywalls: Bezahlschranken sind zulässig, solange Google denselben Inhalt sieht wie zahlende Abonnenten und die Regeln für flexibles Sampling eingehalten werden.
  • JavaScript und Bilder: Inhalte, die erst per JavaScript entstehen oder in Bildern stecken, erschweren Crawlern zwar den Zugriff, gelten aber ohne Täuschungsabsicht nicht als Cloaking.
  • Personalisierung und Geo-Anpassung: Unterschiedliche Sprachen oder regionale Inhalte sind erlaubt, solange der Crawler wie ein normaler Besucher derselben Region behandelt wird.

Wie erkennst du Cloaking auf deiner Website?

Cloaking betrifft nicht nur Täter: Gehackte Websites liefern häufig Spam-Inhalte an Crawler aus, während der Betreiber im Browser eine normale Seite sieht. Der zuverlässigste Test ist die URL-Prüfung in der Google Search Console: Sie zeigt das HTML, das der Googlebot tatsächlich erhält. Weicht dieses HTML sichtbar vom Browser-Inhalt ab, liegt ein Problem vor. Ein systematischer Abgleich aller wichtigen Seiten gehört deshalb in jedes SEO-Audit.

Häufige Fragen zu Cloaking

Ist Cloaking illegal?
Cloaking ist kein Straftatbestand, aber ein Verstoß gegen Googles Spam-Richtlinien. Die Konsequenzen betreffen die Sichtbarkeit: Abwertung, manuelle Maßnahme oder Entfernung aus dem Index.

Ist ein Geo-Redirect Cloaking?
Nein, solange alle Besucher aus derselben Region gleich behandelt werden, der Crawler eingeschlossen. Problematisch wird es erst, wenn Crawler gezielt andere Inhalte erhalten als Menschen.

Was unterscheidet Cloaking von Doorway Pages?
Doorway Pages sind eigens für Suchmaschinen erstellte Brückenseiten, die Besucher direkt weiterleiten. Cloaking liefert dagegen unter derselben URL zwei verschiedene Inhalte aus. Beides verstößt gegen Googles Spam-Richtlinien.

Cumulative Layout Shift

Was ist Cumulative Layout Shift (CLS)?

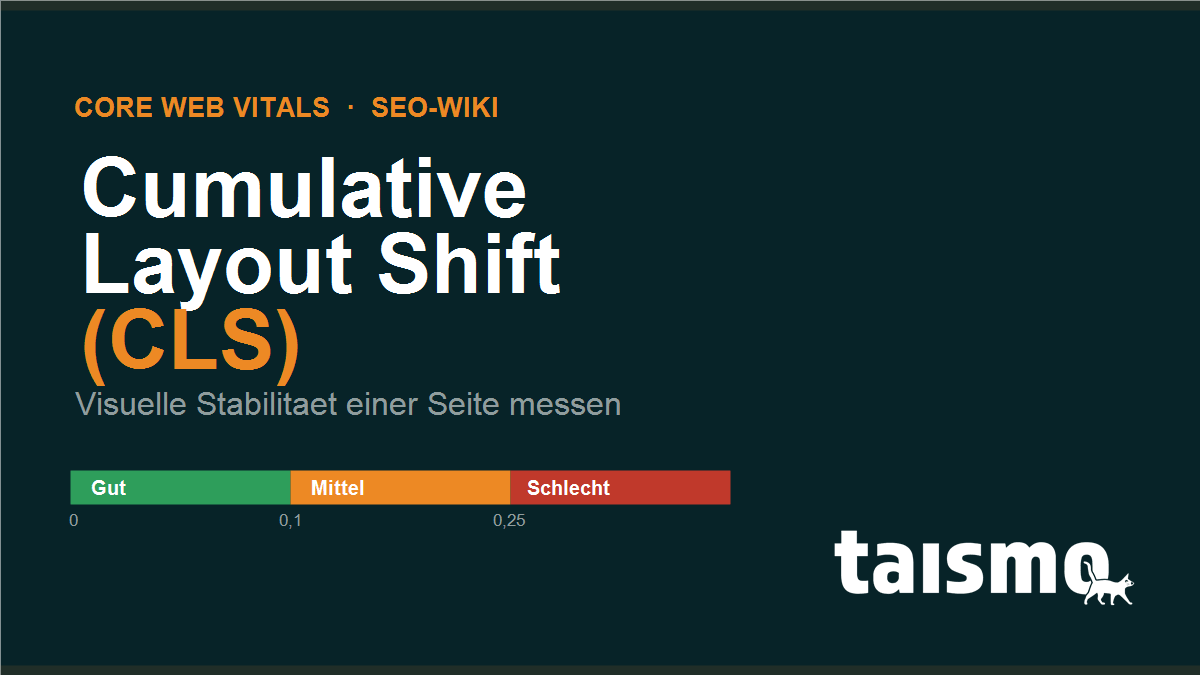
Cumulative Layout Shift (CLS) ist eine der drei Core Web Vitals von Google und misst die visuelle Stabilität einer Webseite. Die Metrik erfasst, wie stark sich sichtbare Inhalte während des Ladens unerwartet verschieben – etwa wenn ein nachgeladenes Bild den bereits gelesenen Text nach unten springen lässt. Als gut gilt ein CLS-Wert von 0,1 oder weniger, gemessen am 75. Perzentil aller realen Seitenaufrufe.

Cumulative Layout Shift (CLS) erklärt: Core-Web-Vitals-Skala für visuelle Stabilität mit den Schwellenwerten 0,1 und 0,25

CLS gehört seit 2021 zu den offiziellen Core Web Vitals, mit denen Google die Nutzererfahrung einer Seite bewertet. Während Largest Contentful Paint die Ladegeschwindigkeit und Interaction to Next Paint die Reaktionsfähigkeit misst, steht CLS für die visuelle Ruhe: Nichts soll unter den Fingern des Nutzers wegrutschen, während die Seite noch lädt.

Kurzprofil des Begriffs

Merkmal Angabe
Kategorie Core Web Vital (Feldmetrik zur visuellen Stabilität)
Abkürzung CLS (englisch Cumulative Layout Shift)
Einheit dimensionslose Zahl (kein Zeitwert, keine Sekunden)
Guter Wert ≤ 0,1 · verbesserungswürdig 0,1–0,25 · schlecht > 0,25
Bewertungspunkt 75. Perzentil aller Seitenaufrufe (Mobil und Desktop getrennt)
Verwandte Metriken Largest Contentful Paint (LCP), Interaction to Next Paint (INP)

Was misst Cumulative Layout Shift genau?

CLS misst die Summe aller unerwarteten Layout-Verschiebungen, die während der gesamten Lebensdauer einer Seite auftreten. Eine Layout-Verschiebung passiert immer dann, wenn ein bereits sichtbares Element seine Position zwischen zwei gerenderten Frames ändert, ohne dass der Nutzer eine Aktion ausgelöst hat.

Der Wert jeder einzelnen Verschiebung ergibt sich aus zwei Faktoren, die miteinander multipliziert werden:

  • Impact Fraction – wie viel Anteil des sichtbaren Bildschirms von der Verschiebung betroffen ist.
  • Distance Fraction – wie weit sich das Element relativ zum Viewport verschoben hat.

Ein Element, das die halbe Bildschirmhöhe einnimmt und um ein Viertel der Höhe nach unten rutscht, erzeugt also einen Layout-Shift-Score von 0,5 × 0,25 = 0,125. Wichtig: Seit 2021 summiert CLS nicht mehr alle Verschiebungen einer Sitzung, sondern nur die stärkste zusammenhängende Verschiebungsphase (das sogenannte Session Window). Das verhindert, dass langlebige Single-Page-Anwendungen künstlich schlechte Werte anhäufen.

Nur unerwartete Verschiebungen zählen. Bewegt sich Content als direkte Reaktion auf einen Klick oder eine Tastatureingabe innerhalb von 500 Millisekunden, wird die Verschiebung nicht gewertet – der Nutzer hat sie ja selbst ausgelöst.

Was ist ein guter CLS-Wert?

Ein guter CLS-Wert liegt bei 0,1 oder darunter. Google teilt die Skala in drei Bereiche: bis 0,1 gilt eine Seite als „gut“, zwischen 0,1 und 0,25 als „verbesserungswürdig“ und über 0,25 als „schlecht“. Entscheidend ist dabei nicht der beste oder der durchschnittliche Messwert, sondern das 75. Perzentil – also der Wert, den 75 Prozent aller echten Seitenaufrufe erreichen oder unterbieten.

CLS-Bewertungsskala mit den Schwellenwerten 0,1 und 0,25Google bewertet CLS in drei Stufen: gut bis 0,1, verbesserungswuerdig zwischen 0,1 und 0,25 und schlecht ab 0,25. Gemessen wird am 75. Perzentil der realen Seitenaufrufe.CLS-Bewertung am 75. PerzentilGutVerbesserungswürdigSchlecht00,10,25∞Ziel: 75 % aller Seitenaufrufe erreichen einen Wert von 0,1 oder besser.Abb. 1 · taismo
Abb. 1: Die CLS-Bewertungsskala mit den Schwellenwerten 0,1 und 0,25.

Weil das 75. Perzentil zählt, reicht es nicht, wenn die Seite auf dem eigenen schnellen Testgerät stabil lädt. Google stützt sich auf die Felddaten echter Nutzer mit unterschiedlichen Geräten und Verbindungen. Ein einzelnes ruckelndes Banner auf langsamen Smartphones kann den Wert bereits über die Marke drücken.

Was verursacht Layout-Shifts?

Layout-Shifts entstehen fast immer dadurch, dass der Browser Platz für ein Element reservieren muss, das erst später eintrifft, und den bereits gerenderten Content dafür verschiebt. Die häufigsten Ursachen:

  1. Bilder ohne Größenangabe: Fehlen width und height (oder eine aspect-ratio), kennt der Browser die Bildmaße erst beim Laden und schiebt den Folge-Content nach unten. Das passende Bildformat ändert daran nichts – entscheidend ist die reservierte Fläche.
  2. Werbung, Embeds und iframes ohne feste Maße: Anzeigen, Social-Media-Einbettungen oder Videoplayer laden asynchron und drücken vorhandenen Content weg, wenn kein Platzhalter definiert ist.
  3. Dynamisch nachgeladener Content: Cookie-Banner, Newsletter-Boxen oder „Ähnliche Artikel“, die per JavaScript oberhalb bestehender Inhalte eingefügt werden.
  4. Webfonts (FOIT/FOUT): Wenn eine Schrift nachgeladen wird und der Text von der Ersatz- auf die Zielschrift umbricht, verändern sich Zeilenlängen und Höhen.
  5. Unsauberes Lazy Loading: Verzögert geladene Bilder ohne reservierte Fläche verschieben das Layout genau in dem Moment, in dem der Nutzer scrollt.
Layout-Shift durch ein nachgeladenes Bild ohne reservierten PlatzOhne reservierte Bildflaeche springt der Text nach dem Laden nach unten (Layout-Shift). Mit reserviertem Platz per width und height bleibt der Text an seiner Stelle stabil.Ohne reservierten PlatzMit width & heightÜberschriftBild lädt nachÜberschriftPlatz reserviertReservierte Fläche verhindert, dass der Text beim Nachladen wegspringt.Abb. 2 · taismo
Abb. 2: Nachgeladenes Bild ohne reservierten Platz (links) drückt den Text weg – mit fester Größe (rechts) bleibt das Layout stabil.

Wie wird CLS gemessen?

CLS wird auf zwei Wegen erhoben: über Felddaten echter Nutzer und über Labortests. Für die Google-Bewertung zählen ausschließlich die Felddaten.

  • Felddaten (Field Data): Der Chrome User Experience Report (CrUX) sammelt CLS-Werte anonym von echten Chrome-Nutzern. Diese Daten fließen in PageSpeed Insights und in den Core-Web-Vitals-Bericht der Google Search Console ein – die Grundlage der eigentlichen Bewertung.
  • Labordaten (Lab Data): Werkzeuge wie Lighthouse oder die Chrome DevTools simulieren einen einzelnen Seitenaufruf unter kontrollierten Bedingungen. Sie eignen sich zur Ursachensuche, spiegeln aber nicht das reale Nutzerspektrum wider.
  • JavaScript-Messung: Die offene web-vitals-Bibliothek von Google erfasst CLS direkt im Browser und lässt sich an jedes Analyse-Tool anbinden.

Ein Unterschied ist zentral: Lab-Tools messen CLS nur bis zum initialen Laden, Felddaten erfassen die gesamte Sitzung inklusive Scrollen und Interaktion. Deshalb kann ein Lighthouse-Wert grün sein, während die Search Console rot meldet.

Wie reduziert man CLS?

CLS reduziert man, indem man dem Browser von Anfang an mitteilt, wie viel Platz jedes Element braucht. Die wirksamsten Maßnahmen:

  1. Bild- und Videomaße setzen: Immer width und height (oder aspect-ratio in CSS) angeben, damit der Browser die Fläche vorab reserviert.
  2. Platz für Werbung und Embeds reservieren: Feste Container-Höhen für Anzeigen, iframes und dynamische Boxen definieren, statt sie den Content wegdrücken zu lassen.
  3. Keinen Content über bestehendem einfügen: Banner und Hinweise unterhalb oder als Overlay statt oberhalb des sichtbaren Inhalts platzieren.
  4. Webfonts optimieren: font-display: optional oder swap mit passender Fallback-Schrift nutzen und die wichtigste Schrift vorab laden (preload).
  5. Animationen über transform lösen: Bewegungen mit transform statt mit layout-auslösenden Eigenschaften wie top oder height umsetzen.

In der Praxis lohnt es sich, mit den größten sichtbaren Elementen zu beginnen – dort wirkt jede Korrektur am stärksten auf den Score. Wer nicht weiß, welche Elemente die Verschiebung auslösen, findet die Verursacher im Bericht der Search Console oder in der Ebene „Layout Shift“ der Chrome DevTools. Eine strukturierte technische Prüfung dieser und der übrigen Core Web Vitals ist fester Bestandteil eines SEO-Audits.

Häufige Fragen zu CLS

Ist CLS ein Rankingfaktor?
Ja, CLS ist Teil der Core Web Vitals und damit ein bestätigtes, wenn auch schwaches Rankingsignal. Bei vergleichbarer Relevanz kann ein guter CLS-Wert den Ausschlag geben, ersetzt aber keine starken Inhalte.

Warum ist mein CLS auf dem Handy schlechter als am Desktop?
Auf Smartphones ist der Viewport kleiner und die gleiche Verschiebung nimmt relativ mehr Bildschirm ein. Zudem laden mobile Verbindungen Bilder und Anzeigen langsamer nach, was Layout-Shifts begünstigt.

Zählt eine Verschiebung nach einem Klick zum CLS?
Nein, Verschiebungen, die innerhalb von 500 Millisekunden auf eine Nutzeraktion folgen, gelten als erwartet und fließen nicht in den CLS-Wert ein.

Crawl-Budget

Was ist das Crawl-Budget?

Das Crawl-Budget ist die Anzahl an URLs, die der Googlebot innerhalb eines bestimmten Zeitraums auf einer Website crawlt. Es ergibt sich aus zwei Faktoren: dem Crawl-Kapazitätslimit – wie viele Anfragen ein Server verträgt, ohne langsamer zu werden – und dem Crawl-Bedarf – wie wichtig und aktuell Google die Inhalte einschätzt. Für die meisten kleinen Websites ist das Crawl-Budget kein Thema; relevant wird es vor allem bei großen Websites mit vielen Tausend URLs.

Crawl-Budget erklärt: Wie viele URLs der Googlebot in einem Zeitraum crawlt, aus Crawl-Kapazitätslimit und Crawl-Bedarf

Das Crawl-Budget beschreibt keine feste Zahl, die Google einer Website zuweist, sondern das Ergebnis aus Serverleistung und Nachfrage. Der Crawler ruft Seiten ab, folgt Links und meldet die Inhalte zur Indexierung. Je mehr URLs eine Website hat, desto stärker konkurrieren diese Seiten um die begrenzte Zahl an Abrufen – und desto wichtiger wird ein sauberes Crawl-Budget-Management.

Kurzprofil des Begriffs

Merkmal Angabe
Begriff Crawl-Budget (auch: Crawling-Budget)
Bereich Technisches SEO, Crawling & Indexierung
Bestandteile Crawl-Kapazitätslimit (crawl rate limit) + Crawl-Bedarf (crawl demand)
Zuständiger Bot Googlebot (analog: Bingbot und andere Suchmaschinen-Crawler)
Relevant ab Websites mit mehreren Tausend bis Millionen URLs
Verwandte Begriffe Crawler, robots.txt, Sitemap, Indexierung, Duplicate Content

Wie bestimmt Google das Crawl-Budget?

Google bestimmt das Crawl-Budget aus zwei Größen, die zusammenwirken: dem Crawl-Kapazitätslimit und dem Crawl-Bedarf. Das eine legt fest, wie viel gecrawlt werden kann, das andere, wie viel gecrawlt werden soll.

  • Crawl-Kapazitätslimit (crawl capacity limit): die maximale Zahl gleichzeitiger Verbindungen, die der Googlebot zu einer Website öffnet, ohne den Server zu überlasten. Antwortet der Server schnell und fehlerfrei, hebt Google das Limit an. Wird er langsam oder liefert Serverfehler (5xx), drosselt Google das Crawling automatisch.
  • Crawl-Bedarf (crawl demand): wie stark Google eine Website crawlen will. Er steigt mit der Popularität der URLs, ihrer Aktualität und der Häufigkeit von Änderungen. Beliebte und häufig aktualisierte Seiten werden öfter besucht, verwaiste oder statische Seiten seltener.

Das tatsächliche Crawl-Budget ist die kleinere der beiden Grenzen: Selbst wenn der Server viel verträgt, crawlt Google nicht mehr, als der Bedarf hergibt – und umgekehrt bremst ein schwacher Server auch bei hohem Bedarf das Crawling aus.

Zusammensetzung des Crawl-Budgets aus Crawl-Kapazitaetslimit und Crawl-BedarfDas Crawl-Budget ergibt sich aus zwei Faktoren: dem Crawl-Kapazitaetslimit, also wie viele Anfragen der Server vertraegt, und dem Crawl-Bedarf, also wie gefragt und aktuell Google die Inhalte einschaetzt.Woraus sich das Crawl-Budget zusammensetztCrawl-KapazitaetslimitWie viele Anfragen derServer vertraegt.+Crawl-BedarfWie gefragt und aktuelldie Inhalte sind.Crawl-BudgetURLs pro ZeitraumAbb. 1 · taismo
Abb. 1: Das Crawl-Budget als Ergebnis aus Crawl-Kapazitätslimit und Crawl-Bedarf.

Wie viel Google auf einer Website tatsächlich crawlt, lässt sich im Bericht „Crawling-Statistiken“ der Google Search Console nachvollziehen – inklusive Anzahl der Anfragen pro Tag, durchschnittlicher Antwortzeit und der zurückgegebenen Statuscodes.

Für wen ist das Crawl-Budget relevant?

Das Crawl-Budget ist vor allem für große Websites mit sehr vielen URLs relevant. Google selbst nennt in seiner Dokumentation als Faustregel: Erst ab etwa 10.000 URLs oder bei häufig wechselnden Inhalten lohnt es sich, das Crawl-Budget aktiv zu steuern.

Konkret betroffen sind unter anderem:

  • Große Onlineshops mit Tausenden Produkt-, Kategorie- und Filterseiten.
  • Nachrichten- und Verlagsseiten, die täglich viele neue Artikel veröffentlichen und auf schnelle Indexierung angewiesen sind.
  • Portale und Verzeichnisse mit dynamisch generierten Seiten, etwa Jobbörsen oder Immobilienplattformen.

Für eine typische Unternehmenswebsite mit einigen Hundert Seiten ist das Crawl-Budget dagegen kein Engpass: Google crawlt solche Seiten in aller Regel vollständig. Hier zahlt sich die Arbeit an Inhaltsqualität und Seitenstruktur stärker aus als an der Crawl-Steuerung. Trotzdem gilt: Was den Crawler schont, verbessert fast immer auch die technische Gesundheit einer Website insgesamt.

Was verschwendet Crawl-Budget?

Crawl-Budget wird immer dann verschwendet, wenn der Googlebot Zeit auf URLs verwendet, die keinen indexierbaren Mehrwert bieten. Jeder Abruf einer minderwertigen oder doppelten Seite geht von der Kapazität für die wirklich wichtigen Seiten ab.

Fuenf typische Crawl-Budget-FresserCrawl-Budget wird vor allem durch endlose URL-Parameter und Filter, Duplicate Content, Soft-404- und Fehlerseiten, lange Weiterleitungsketten sowie durch minderwertige oder verwaiste Seiten verschwendet.5 typische Crawl-Budget-FresserEndlose URL-Parameter, Filter und SortierungenDuplicate Content (mehrere URLs, gleicher Inhalt)Soft-404- und Fehlerseiten (200-Status ohne Inhalt)Lange Weiterleitungsketten und Redirect-SchleifenMinderwertige, verwaiste und endlose Kalender-SeitenAbb. 2 · taismo
Abb. 2: Fünf typische Crawl-Budget-Fresser, die Googlebot-Abrufe an unwichtige URLs binden.

Die häufigsten Ursachen im Detail:

  1. Facettierte Navigation und URL-Parameter: Filter, Sortierungen und Session-IDs erzeugen unzählige URL-Varianten desselben Inhalts. In Onlineshops ist das der größte Budget-Fresser überhaupt.
  2. Duplicate Content: Sind identische Inhalte über mehrere URLs erreichbar, crawlt Google jede Variante – und verschwendet Budget an Dubletten.
  3. Soft-404- und Fehlerseiten: Seiten, die den Status 200 zurückgeben, aber leer oder inhaltslos sind, binden Abrufe ohne Gegenwert.
  4. Weiterleitungsketten: Jede zusätzliche Weiterleitung in einer Kette kostet einen weiteren Abruf, bevor die eigentliche Seite erreicht wird.
  5. Minderwertige und verwaiste Seiten: Thin Content, endlose Kalender-Archive oder verwaiste Seiten ohne interne Verlinkung senken den Gesamtwert einer Website und ziehen Bedarf von den starken Seiten ab.

Wie optimiert man das Crawl-Budget?

Crawl-Budget optimiert man, indem man dem Googlebot die wichtigen Seiten leicht zugänglich macht und unwichtige URLs konsequent vom Crawling ausschließt. Ziel ist, dass jeder Abruf auf einer indexierbaren, wertvollen Seite landet.

  • Crawling steuern per robots.txt: URLs ohne Suchwert – Filterparameter, interne Suchergebnisse, Warenkorb – vom Crawling ausschließen. Die robots.txt verhindert das Crawling, nicht die Indexierung bereits bekannter URLs.
  • Indexierung steuern per Noindex und X-Robots-Tag: Soll eine Seite gecrawlt, aber nicht indexiert werden, ist ein noindex per Meta-Tag oder HTTP-Header der richtige Weg. Wichtig: Eine per robots.txt gesperrte Seite kann Google das noindex nicht lesen.
  • Saubere Sitemap pflegen: Die XML-Sitemap sollte nur indexierbare, kanonische URLs mit Statuscode 200 enthalten. Sie ist der wichtigste Hinweis an Google, welche Seiten Priorität haben.
  • Serverleistung verbessern: Schnelle Antwortzeiten heben das Crawl-Kapazitätslimit. Ein performanter Server, Caching und ein CDN erlauben dem Googlebot, mehr Seiten in gleicher Zeit abzurufen.
  • Weiterleitungsketten auflösen: Redirects direkt auf das finale Ziel zeigen lassen, statt über mehrere Zwischenstationen.
  • Interne Verlinkung stärken: Wichtige Seiten flach verlinken und verwaiste Seiten anbinden oder entfernen. Eine klare Struktur führt den Crawler gezielt zu den relevanten Inhalten.

Welche dieser Hebel im Einzelfall zählen, zeigt eine strukturierte Analyse der Server-Logs und der Crawling-Statistiken. Genau diese technische Bestandsaufnahme ist Teil eines professionellen SEO-Audits, das Crawling-Verschwendung sichtbar macht und die stärksten Hebel priorisiert.

Häufige Fragen zum Crawl-Budget

Ist das Crawl-Budget ein Rankingfaktor?
Nein, das Crawl-Budget ist kein direkter Rankingfaktor. Es beeinflusst nur, wie schnell und vollständig Google Seiten crawlt und indexiert. Wird eine wichtige Seite gar nicht erst gecrawlt, kann sie aber auch nicht ranken – insofern ist ausreichendes Crawling die Voraussetzung für Sichtbarkeit.

Muss ich mich als kleine Website um mein Crawl-Budget kümmern?
In der Regel nein. Websites mit einigen Hundert bis wenigen Tausend URLs crawlt Google meist vollständig. Erst ab etwa 10.000 URLs oder bei sehr häufigen Inhaltsänderungen wird die aktive Steuerung des Crawl-Budgets zum Thema.

Erhöht eine höhere Crawl-Frequenz mein Ranking?
Nein. Häufigeres Crawling sorgt lediglich dafür, dass Änderungen schneller in den Index gelangen. Die Bewertung der Inhalte erfolgt unabhängig davon über die eigentlichen Rankingsignale.

Wo sehe ich, wie viel Google auf meiner Website crawlt?
Im Bericht „Crawling-Statistiken“ der Google Search Console. Er zeigt die Zahl der Crawling-Anfragen, die durchschnittliche Antwortzeit des Servers und die verteilten Statuscodes über die Zeit.

Core Web Vitals

Was sind Core Web Vitals?

Core Web Vitals sind drei von Google definierte Messwerte, die die Nutzererfahrung einer Webseite technisch bewerten: Ladegeschwindigkeit, Reaktionsfähigkeit und visuelle Stabilität. Die drei Core Web Vitals heißen Largest Contentful Paint (LCP), Interaction to Next Paint (INP) und Cumulative Layout Shift (CLS). Google misst sie an echten Nutzerdaten und nutzt sie als Teil des Ranking-Signals „Page Experience“. Erreicht eine Seite in allen drei Werten den grünen Bereich, gilt sie als schnell, bedienbar und stabil.

Core Web Vitals erklärt: die drei Kennzahlen LCP, INP und CLS für Ladezeit, Reaktion und Stabilität

Core Web Vitals übersetzen ein diffuses Gefühl in klare Zahlen: Statt „die Seite fühlt sich langsam an“ gibt es einen Sekundenwert für den Seitenaufbau, einen Millisekundenwert für die Reaktion auf Klicks und einen Punktwert für ruckelnde Layouts. Genau diese Messbarkeit macht die Core Web Vitals zum zentralen KPI der technischen SEO.

Kurzprofil des Begriffs

Merkmal Angabe
Wortart Substantiv, Plural (die Core Web Vitals)
Aussprache „kor web weitels“
Silbentrennung Core Web Vi·tals
Anzahl 3 Metriken: LCP, INP, CLS
Verwandte Begriffe Page Experience, PageSpeed, Lighthouse, CrUX, Ladezeit

Welche drei Core Web Vitals gibt es?

Es gibt genau 3 Core Web Vitals, und jeder misst eine andere Dimension der Nutzererfahrung. Jede Metrik hat feste Richtwerte, die Google in „gut“, „verbesserungswürdig“ und „schlecht“ einteilt.

  1. Largest Contentful Paint (LCP) – Ladezeit. LCP misst, wie lange es dauert, bis das größte sichtbare Element im Sichtbereich geladen ist, meist ein Bild oder eine Überschrift. Gut ist ein Wert von ≤ 2,5 Sekunden, schlecht sind mehr als 4,0 Sekunden.
  2. Interaction to Next Paint (INP) – Reaktionsfähigkeit. INP misst, wie schnell die Seite auf Eingaben wie Klicks oder Tippen sichtbar reagiert. Gut ist ein Wert von ≤ 200 Millisekunden, schlecht sind mehr als 500 Millisekunden.
  3. Cumulative Layout Shift (CLS) – visuelle Stabilität. CLS misst, wie stark sich Elemente während des Ladens unerwartet verschieben. Der Wert ist dimensionslos. Gut ist ein Wert von ≤ 0,1, schlecht sind mehr als 0,25.
Die drei Core Web Vitals und ihre RichtwerteUebersicht der drei Core Web Vitals LCP, INP und CLS mit den Google-Richtwerten fuer gut, verbesserungswuerdig und schlecht. LCP gut bei 2,5 Sekunden oder weniger, INP gut bei 200 Millisekunden oder weniger, CLS gut bei 0,1 oder weniger.Die 3 Core Web Vitals und ihre RichtwerteGoogle bewertet jede Metrik am 75. Perzentil echter Nutzer.LCPLadezeitgut≤ 2,5 smittel2,5–4 sschlecht> 4 sINPReaktiongut≤ 200 msmittel200–500 msschlecht> 500 msCLSStabilitätgut≤ 0,1mittel0,1–0,25schlecht> 0,25Abb. 1 · taismo
Abb. 1: Die drei Core Web Vitals LCP, INP und CLS mit den Google-Richtwerten für gut, verbesserungswürdig und schlecht.

Ein Wert im gelben Bereich („verbesserungswürdig“) reicht nicht: Google zählt eine Seite erst dann als „bestanden“, wenn alle drei Core Web Vitals im grünen Bereich liegen.

Wie werden Core Web Vitals gemessen?

Core Web Vitals werden auf zwei Arten gemessen: mit Felddaten und mit Labordaten. Beide beantworten unterschiedliche Fragen.

  • Felddaten (Field Data): anonyme Messungen echter Chrome-Nutzer, gesammelt im Chrome User Experience Report (CrUX) über 28 Tage. Diese Daten fließen ins Ranking ein, weil sie die reale Erfahrung abbilden.
  • Labordaten (Lab Data): simulierte Messungen unter standardisierten Bedingungen, etwa mit Lighthouse. Sie sind reproduzierbar und ideal zum Debuggen, spiegeln aber keine echten Geräte und Netze wider.

Entscheidend ist das 75. Perzentil: Google bewertet nicht den Durchschnitt, sondern den Wert, den 75 % der Nutzer erreichen oder unterbieten. Eine Seite besteht nur, wenn drei von vier Besuchern eine gute Erfahrung haben. Die wichtigsten Werkzeuge sind PageSpeed Insights, der Core-Web-Vitals-Bericht in der Google Search Console und die Chrome DevTools.

Was wurde aus FID?

INP hat FID ersetzt. Bis zum 12. März 2024 war First Input Delay (FID) die dritte Core-Web-Vitals-Metrik für Interaktivität. FID maß nur die Verzögerung der allerersten Eingabe, nicht die Reaktion auf spätere Klicks.

Interaction to Next Paint bewertet dagegen alle Interaktionen einer Sitzung und meldet die langsamste, statt nur den ersten Kontakt. INP ist damit strenger und näher an der tatsächlichen Bedienbarkeit. Wer noch alte Audits mit FID vorliegen hat, sollte die Werte neu erheben, weil FID seit 2024 kein Core Web Vital mehr ist.

Warum sind Core Web Vitals wichtig für SEO?

Core Web Vitals sind ein bestätigter Google-Rankingfaktor, eingebettet ins Signal „Page Experience“. Bei ähnlich relevanten Inhalten kann die schnellere, stabilere Seite besser ranken. Der Effekt ist kein Turbo, sondern ein Tiebreaker: Guter Content bleibt die Grundlage, schlechte Core Web Vitals bremsen ihn aber aus.

Der zweite Hebel ist die Conversion. Langsame Seiten und springende Layouts erhöhen die Absprungrate, weil Nutzer abbrechen, bevor die Seite bedienbar ist. Schnelle Core Web Vitals verbessern damit zwei Ziele gleichzeitig: Sichtbarkeit in der Suche und Verhalten der Besucher auf der Seite. Deshalb sind die Werte fester Bestandteil jedes technischen SEO-Audits.

Wie verbessert man die Core Web Vitals?

Jede der drei Metriken hat eigene Stellschrauben. Wer die Core Web Vitals verbessern will, optimiert gezielt pro Wert statt pauschal.

  • LCP verbessern: Serverantwort (TTFB) beschleunigen, ein Content Delivery Network (CDN) und Cache einsetzen, Bilder in modernen Bildformaten wie WebP ausliefern und das LCP-Element vorladen. Wichtig: das größte Bild im Sichtbereich niemals per Lazy Loading verzögern.
  • INP verbessern: lange JavaScript-Aufgaben aufteilen, Arbeit vom Haupt-Thread nehmen, unnötige Skripte von Drittanbietern entfernen und Eingabe-Handler schlank halten.
  • CLS verbessern: feste Breite und Höhe (oder aspect-ratio) für Bilder und Einbettungen setzen, Platz für Werbung und Banner reservieren und Webfonts vorladen, damit kein Text nachträglich umbricht.
Optimierungshebel je Core-Web-Vitals-MetrikJe Metrik gibt es eigene Stellschrauben. LCP verbessert man ueber Serverantwort, CDN, Cache, WebP-Bilder und Vorladen des LCP-Elements. INP ueber das Aufteilen von JavaScript und Entlasten des Haupt-Threads. CLS ueber feste Bildmasse, reservierten Platz und vorgeladene Webfonts.So verbesserst du jede Metrik gezieltLCPLadezeitServerantwort (TTFB) senkenCDN und Cache nutzenBilder als WebP ausliefernLCP-Element vorladenINPReaktionJavaScript aufteilenHaupt-Thread entlastenDritt-Skripte reduzierenEingabe-Handler schlank haltenCLSStabilitätBildmaße fest setzenPlatz für Banner reservierenWebfonts vorladenaspect-ratio verwendenAbb. 2 · taismo
Abb. 2: Die wichtigsten Optimierungshebel je Core-Web-Vitals-Metrik – LCP, INP und CLS werden getrennt optimiert.

Die meisten Probleme lassen sich technisch lösen, ohne den Inhalt anzufassen. Wo Theme, Hosting oder Plugins die Werte drücken, hilft eine laufende SEO-Betreuung, die die Core Web Vitals dauerhaft im grünen Bereich hält.

Häufige Fragen zu Core Web Vitals

Wie viele Core Web Vitals gibt es?
Es gibt 3 Core Web Vitals: Largest Contentful Paint (LCP) für die Ladezeit, Interaction to Next Paint (INP) für die Reaktionsfähigkeit und Cumulative Layout Shift (CLS) für die visuelle Stabilität.

Sind Core Web Vitals ein Rankingfaktor?
Ja, Core Web Vitals sind Teil des Google-Signals „Page Experience“. Der Einfluss ist moderat und wirkt vor allem als Tiebreaker zwischen inhaltlich vergleichbaren Seiten.

Was ist ein guter LCP-Wert?
Ein guter LCP-Wert liegt bei 2,5 Sekunden oder darunter, gemessen am 75. Perzentil echter Nutzer. Zwischen 2,5 und 4,0 Sekunden gilt der Wert als verbesserungswürdig, über 4,0 Sekunden als schlecht.

Wo sehe ich die Core Web Vitals meiner Website?
Die Core Web Vitals findest du in PageSpeed Insights, im Core-Web-Vitals-Bericht der Google Search Console und in den Chrome DevTools. Search Console zeigt Felddaten echter Nutzer, PageSpeed Insights kombiniert Feld- und Labordaten.

CTR


Was bedeutet CTR?

Die Click Through Rate (CTR) ist ein maßgeblicher Leistungsindikator im digitalen Marketing und in der Suchmaschinenoptimierung (SEO). Sie misst das Verhältnis der Anzahl der Klicks auf einen bestimmten Link oder eine Anzeige zur Anzahl der Gesamteindrücke (Impressions) dieses Links oder dieser Anzeige. Die CTR wird oft verwendet, um zu beurteilen, wie effektiv eine Online-Werbekampagne ist oder wie relevant und ansprechend ein Suchergebnis oder eine Werbeanzeige für die Nutzer ist.

Die CTR ist besonders wichtig im Kontext von Online-Werbekampagnen und Suchmaschinenresultaten. Eine hohe CTR weist darauf hin, dass der Inhalt oder die Anzeige für die Zielgruppe relevant und ansprechend ist. Im Gegensatz dazu kann eine niedrige CTR darauf hindeuten, dass die Anzeige oder der Inhalt nicht ansprechend genug ist oder nicht der Zielgruppe entspricht.

Wie berechnet man die CTR?

Die Berechnung der CTR ist relativ einfach und erfolgt nach folgender Formel:
CTR= ( Anzahl der Impressions / Anzahl der Klicks ) ×100
In dieser Formel ist die „Anzahl der Klicks“ die Anzahl der Male, die Nutzer auf den Link oder die Anzeige geklickt haben. Die „Anzahl der Impressions“ ist die Anzahl der Male, die der Link oder die Anzeige einem Nutzer angezeigt wurde. Das Ergebnis wird dann mit 100 multipliziert, um die CTR als Prozentsatz auszudrücken.

Was sagt die CTR über SEO aus?

In der Suchmaschinenoptimierung (SEO) ist die CTR ein wichtiger Indikator dafür, wie gut eine Webseite oder ein Inhalt mit den Suchanfragen der Nutzer übereinstimmt. Eine hohe CTR in den Suchmaschinenergebnissen (SERPs) deutet darauf hin, dass der Titel und die Meta-Beschreibung der Seite effektiv gestaltet sind und die Nutzer dazu anregen, auf den Link zu klicken.

Eine hohe CTR kann außerdem ein Signal für Suchmaschinen sein, dass eine Webseite für eine bestimmte Suchanfrage relevant ist, was zu einer besseren Platzierung in den SERPs führen kann. Allerdings ist die CTR nur einer von vielen Faktoren, die Suchmaschinen bei der Bestimmung der Rangfolge einer Webseite berücksichtigen.

Die Optimierung der CTR im Rahmen der SEO umfasst daher oft die Verbesserung von Titeln und Meta-Beschreibungen, um sie ansprechender und relevanter für die Zielgruppe zu gestalten. Es geht auch darum, sicherzustellen, dass die Inhalte der Webseite die Erwartungen der Nutzer erfüllen, die durch die Titel und Beschreibungen geweckt wurden. Dadurch können Webseitenbetreiber nicht nur die CTR steigern, sondern auch die Nutzererfahrung verbessern, was wiederum die SEO-Leistung der Webseite positiv beeinflussen kann.

Weiterlesen

Crawler


Was ist ein Crawler?

Ein Crawler (dt. Raupe), oder auch Web Crawler genannt, ist ein Softwareprogramm, welches verstärkt von Suchmaschinen verwendet wird, um das World Wide Web automatisiert zu durchsuchen und einen Index aufzubauen.

Beim Durchsuchen von Websites analysiert und indiziert der Crawler deren Inhalte, damit sie später von Suchmaschinen schneller ausgelesen werden können. Er legt sozusagen die Basis für die Arbeit von Suchmaschinen.

Wie funktioniert ein Webcrawler?

Ein Crawler wird für sich wiederholende Aktionen programmiert und arbeitet somit automatisiert.

Die Informationen, die beim “crawlen” (dt. kriechen) gefunden werden, werden bestimmten Kategorie zugeordnet und anschließend indiziert, somit sind die Informationen danach abruf- und auswertbar. Es werden sowohl Texte, Bilder und Videos als auch Links in die Analyse mit einbezogen.

Verschiedene Arten von Crawlern

Es gibt viele verschiedene Crawler, einige Beispiele wären der Googlebot und der Bingbot, sogar Alexa hat einen eigenen Bot namens ia_archiever.

Crawler können außerdem verschiedene Aufgaben ausführen, wie wie Data-Mining. Dabei wird das Web nach spezifischen Informationen durchsucht. Es können beispielsweise E-Mail Adressen gesucht werden. Das wird zum Teil von Blackhat SEOs verwendet, um danach Spam-Mails an die gesammelten Mail-Adressen zu senden.

Ein weiteres Aufgabengebiet wäre die Plagiatsuche. Diese Funktion ist vor allem wichtig, wenn es um Rechtsbrüche bezüglich urheberrechtlich geschütztem Material geht.

Crawler steuern

Mit Hilfe von Meta-Tags können dem Crawler im <head> Bereich Anweisungen gegeben werden, so kann man unter anderem steuern, ob der Crawler eine Seite indiziert oder einem Link folgt.

Beispiel, für eine Anweisung, dass die Adresse nicht indexiert werden soll und keinen Links gefolgt werden soll:

<meta name=“robots“ content=“noindex,nofollow“>

 Auch mit der robots.txt-Datei können Anweisungen an der Crawler übermittelt werden.

Crawler und SEO

Teil der Suchmaschinenoptimierung ist es, eine Website so zu gestalten, dass sie optimal vom Crawler ausgelesen werden kann, damit alle Inhalte in den Index der Suchmaschine gelangen. Hilfreich ist dabei eine möglichst logische URL-Struktur. Außerdem führen Backlinks sowie übersichtliche interne Verlinkungen dazu, dass der Crawler deine Website öfter und länger besucht.

Weiterlesen

Cornerstone Content


Was ist Cornerstone Content?

Cornerstone Content bezeichnet im Online Marketing wesentliche Inhalte einer Webseite, die als Grundstein oder Eckpfeiler der gesamten Content-Strategie fungieren. Diese Art von Inhalten zeichnet sich durch hohe Qualität, umfassende Informationen und Relevanz für das Kernpublikum aus. Sie bieten einen tiefgehenden Einblick in spezifische Themen und sind meist länger und detaillierter als reguläre Blogposts oder Artikel. Ziel von Cornerstone Content ist es, als zentrale Anlaufstelle für bestimmte Schlüsselthemen zu dienen und somit sowohl für Besucher als auch für Suchmaschinen einen hohen Wert darzustellen.

Beispiele für Cornerstone Content

  1. Umfassende Leitfäden: Ausführliche Anleitungen zu einem Thema, wie z.B. „Der ultimative Leitfaden für Social Media Marketing“.

  2. Grundlegende Lehrartikel: Artikel, die grundlegende Konzepte eines Fachgebiets erklären, wie z.B. „Grundlagen der Suchmaschinenoptimierung“.

  3. Wissensressourcen: Sammlungen von Ressourcen oder Werkzeugen, die für ein Thema relevant sind, wie z.B. „Top-Tools für digitales Marketing“.

  4. Fallstudien und Forschungsergebnisse: Detaillierte Analyse von Projekten oder Forschung, die Einblicke in spezifische Aspekte eines Themas gibt, wie z.B. „Fallstudie zur Steigerung der Conversion-Rate“.

Welchen Einfluss hat Cornerstone Content auf SEO?

Cornerstone Content spielt eine wesentliche Rolle für die Suchmaschinenoptimierung (SEO) einer Website. Durch die Bereitstellung tiefgehender, qualitativ hochwertiger Inhalte werden diese Seiten häufig als Autorität in ihrem Bereich angesehen. Dies kann zu einer höheren Sichtbarkeit in Suchmaschinen führen. Außerdem:

  1. Verbesserte Keyword-Positionierung: Da Cornerstone Content umfassend ist, kann er für eine Vielzahl relevanter Keywords ranken.

  2. Erhöhte Verweildauer: Hochwertiger Content hält Besucher länger auf der Seite, was ein positiver Signalwert für Suchmaschinen ist.

  3. Backlink-Magnet: Wertvolle Inhalte ziehen natürliche Backlinks an, was die Domain-Autorität erhöht und das Ranking verbessert.

  4. Strukturierung der Website: Cornerstone Content hilft dabei, eine klare Struktur auf der Website zu schaffen und zeigt Suchmaschinen die wichtigsten Inhalte der Seite.

Weiterlesen

Cookie Banner


Was ist das Cookie Banner?

Ein Cookie-Banner ist eine Benachrichtigung oder ein Popup-Fenster auf einer Website, das Besucher darüber informiert, dass die Website Cookies und/oder ähnliche Technologien verwendet. Cookies sind kleine Dateien, die auf dem Computer eines Nutzers gespeichert werden, wenn er eine Website besucht. Sie können verschiedene Informationen speichern, von einfachen Einstellungen und Präferenzen bis hin zu Tracking-Informationen, die das Verhalten des Nutzers auf der Website und darüber hinaus verfolgen.

Das Hauptziel des Cookie-Banners ist es, den Besuchern einer Website Transparenz über die Nutzung von Cookies zu bieten und ihre Zustimmung für die Nutzung bestimmter Arten von Cookies zu erhalten, insbesondere wenn diese das Online-Verhalten der Nutzer verfolgen können.

Welche Webseiten brauchen ein Cookie Banner?

Theoretisch können alle Websites, die Cookies verwenden, von einem Cookie-Banner profitieren, da es Transparenz und Vertrauen bei den Nutzern schafft. Rechtlich gesehen ist das Setzen eines Cookie-Banners jedoch oft notwendig, wenn die Website personenbezogene Daten von Nutzern aus der Europäischen Union (EU) oder dem Europäischen Wirtschaftsraum (EWR) sammelt oder verarbeitet.

Dies ist vor allem durch die Datenschutz-Grundverordnung (DSGVO oder auch GDPR) der EU geregelt, die strenge Vorschriften für den Umgang mit personenbezogenen Daten von EU-Bürgern festlegt. Wenn eine Website also Nutzer aus der EU hat und Cookies verwendet, die personenbezogene Daten sammeln oder verarbeiten, muss in den meisten Fällen ein Cookie-Banner eingesetzt werden.

Ist der Cookie Banner nur in Deutschland pflicht?

Die Verpflichtung zur Verwendung eines Cookie-Banners in der gesamten EU durch die DSGVO geregelt. Dies bedeutet, dass alle EU-Mitgliedsstaaten, einschließlich Deutschland, diese Regelung befolgen müssen. Darüber hinaus haben viele andere Länder weltweit ähnliche Datenschutzgesetze eingeführt, die die Verwendung eines Cookie-Banners erfordern oder empfehlen.

Beeinflusst ein Cookie Banner SEO?

Ein Cookie-Banner an sich hat keinen direkten Einfluss auf die Suchmaschinenoptimierung (SEO) einer Website. Es beeinflusst nicht die Crawlbarkeit einer Seite oder wie Suchmaschinen den Inhalt interpretieren. Es kann jedoch indirekte Auswirkungen auf die Nutzererfahrung haben. Ein aufdringlicher oder störender Cookie-Banner kann Besucher abschrecken oder die Benutzerfreundlichkeit einer Seite beeinträchtigen, was sich mittelbar auf die Absprungraten auswirken kann. Da Suchmaschinen, insbesondere Google, den Fokus auf die Nutzererfahrung legen, könnte dies potenziell SEO-Bemühungen beeinflussen. Es ist daher wichtig, dass Cookie-Banner so gestaltet werden, dass sie informativ, aber nicht störend sind.

Weiterlesen

Erfahre Insiderwissen als Erster!
taismo Logo

© taismo GmbH

Adresse


Weißenfelder Str. 6
85551 Kirchheim bei München

Links