Ein Ranking ist die Position, an der eine Webseite in der Ergebnisliste einer Suchmaschine erscheint. Position 1 steht ganz oben in den organischen Ergebnissen, danach folgen die weiteren Treffer in absteigender Reihenfolge. Das Ranking gilt immer für die Kombination aus einer Seite und einer konkreten Suchanfrage: Dieselbe Seite kann für ein Keyword auf Position 3 stehen und für ein anderes gar nicht ranken. Suchmaschinenoptimierung ist die Arbeit daran, diese Positionen für relevante Suchanfragen zu verbessern.
Kurzprofil des Begriffs
Merkmal
Angabe
Wortart
Substantiv, sächlich: das Ranking, die Rankings
Aussprache
„ränking“, aus dem Englischen „to rank“ (einordnen)
Ein Ranking entsteht in 3 Schritten: Crawling, Indexierung, Sortierung. Zuerst liest der Google-Crawler eine Seite aus, dann nimmt Google sie in den Index auf, und bei jeder Suchanfrage sortiert der Ranking-Algorithmus alle passenden Seiten aus dem Index in eine Reihenfolge. Diese Sortierung passiert in Echtzeit und fällt je nach Anfrage unterschiedlich aus.
Ein Ranking ist deshalb keine feste Eigenschaft einer Seite, sondern ein Momentwert. Standort, Endgerät, Sprache und frühere Suchen des Nutzers verändern die Reihenfolge. Wer sein Ranking im eigenen Browser prüft, sieht ein personalisiertes Ergebnis und nicht die neutrale Position.
Gezählt wird dabei nur die organische Liste: Anzeigen, Karten-Einträge und andere SERP-Features stehen außerhalb der organischen Zählung. Position 1 kann deshalb optisch erst im unteren Drittel des Bildschirms beginnen, wenn darüber Anzeigen oder ein Featured Snippet stehen.
Abb. 1: Ein Ranking entsteht in drei Schritten: Google crawlt die Seite, nimmt sie in den Index auf und sortiert sie je Suchanfrage in die Ergebnisliste.
Welche Faktoren beeinflussen ein Ranking?
Google bewertet für jedes Ranking eine Vielzahl von Signalen. Die 4 wichtigsten Gruppen sind:
Relevanz: Wie gut beantwortet der Inhalt die Suchintention hinter der Anfrage? Das ist das stärkste Signal.
Qualität und Vertrauen: Belegte Inhalte, Autorenkompetenz und Backlinks von anderen Websites sprechen für eine Seite.
Nutzbarkeit: Ladezeit, Mobilfreundlichkeit und eine saubere Seitenstruktur.
Kontext: Standort und Sprache des Suchenden, bei lokalen Anfragen die Nähe zum Unternehmen.
Kein einzelner Faktor garantiert eine Position. Rankings verbessern sich, wenn eine Seite die Suchintention vollständiger bedient als die Konkurrenz auf der Suchergebnisseite.
Wie misst du ein Ranking?
Rankings misst du mit zwei Arten von Werkzeugen: Die Google Search Console zeigt die durchschnittliche Position der eigenen Seiten für echte Suchanfragen, Rank-Tracking-Tools prüfen definierte Keywords täglich neutral und ortsbezogen. Wichtig ist die Verlaufsbetrachtung: Eine einzelne Messung ist wegen der ständigen Schwankungen wenig aussagekräftig, erst der Trend über Wochen zeigt, ob eine Seite gewinnt oder verliert.
Wirtschaftlich zählen vor allem die vorderen Positionen: Die Klickrate fällt mit jeder Position deutlich ab, und jenseits der ersten Ergebnisseite findet kaum noch ein Klick statt. Ein Ranking auf Position 40 ist deshalb praktisch unsichtbar, auch wenn die Seite formal rankt. Diese laufende Beobachtung und Verbesserung der Positionen ist der Kern einer kontinuierlichen SEO-Betreuung.
Retrieval Augmented Generation (RAG) ist eine KI-Architektur, die ein großes Sprachmodell mit einem vorgeschalteten Abruf-Schritt kombiniert. Vor der Antwortgenerierung werden relevante Informationen aus einer externen Wissensquelle abgerufen und dem Modell als Kontext mitgegeben. Dadurch reduziert RAG Halluzinationen und liefert aktuelle, belegbare Antworten. RAG ist die Grundlage vieler KI-Suchsysteme wie Perplexity und der Google AI Overviews.
Ein reines Sprachmodell antwortet nur aus dem, was es beim Training gelernt hat. Sein Wissen ist damit auf einen Stichtag eingefroren und lässt sich nicht überprüfen. RAG durchbricht diese Grenze: Das Modell greift zur Laufzeit auf eine aktuelle Wissensbasis zu – etwa eine Dokumentensammlung, eine Datenbank oder das offene Web – und stützt seine Antwort auf diese Fundstellen. Das Ergebnis ist eine Antwort mit Quellenbezug statt aus dem Gedächtnis.
Kurzprofil des Begriffs
Merkmal
Angabe
Begriff
Retrieval Augmented Generation (RAG)
Kategorie
KI-Architektur / Verfahren des maschinellen Lernens
2020 (Forschungsarbeit von Lewis et al., Facebook AI Research)
Wie funktioniert RAG (Retrieval, Augmentation, Generation)?
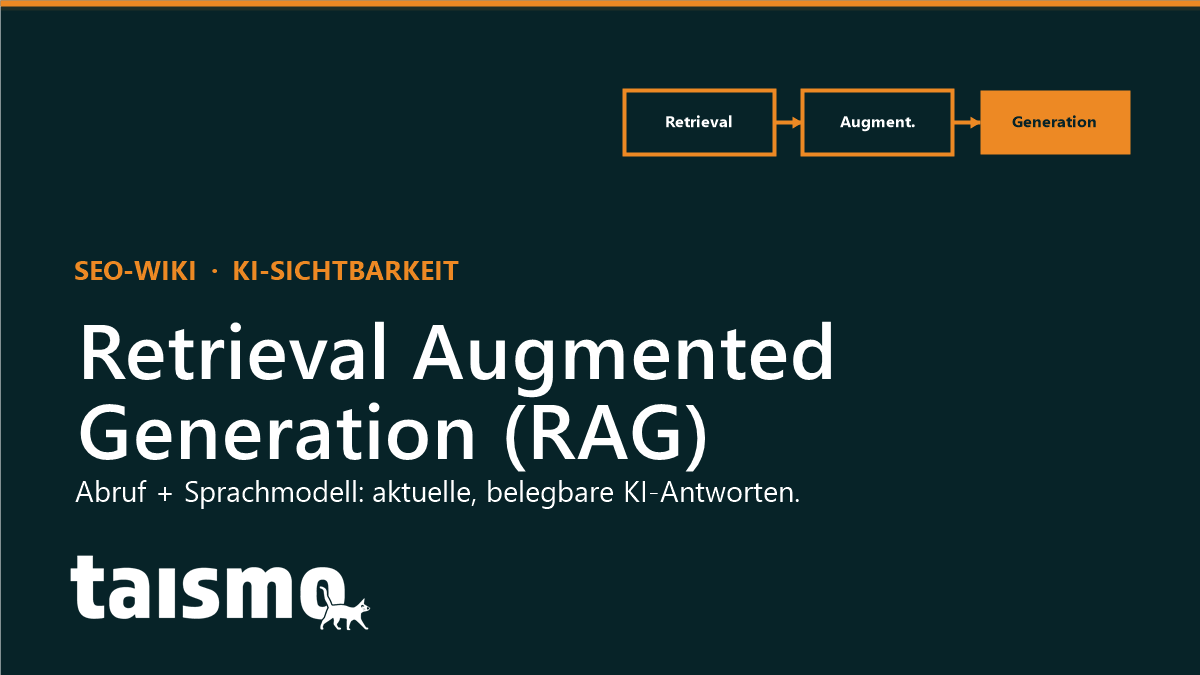
RAG läuft in drei aufeinanderfolgenden Schritten ab, die dem Verfahren seinen Namen geben: erst Abruf, dann Anreicherung, zuletzt Erzeugung. Der entscheidende Unterschied zum reinen Sprachmodell steckt in den ersten beiden Schritten, die vor der eigentlichen Textausgabe passieren.
Retrieval (Abruf): Die Nutzerfrage wird in einen Vektor (ein Embedding) umgewandelt und mit einer Wissensbasis abgeglichen. Eine Vektordatenbank findet die inhaltlich ähnlichsten Textpassagen – nicht über exakte Wortübereinstimmung, sondern über semantische Nähe.
Augmentation (Anreicherung): Die gefundenen Passagen werden dem ursprünglichen Prompt als Kontext beigelegt. Das Modell bekommt die Frage also nicht mehr allein, sondern zusammen mit den relevanten Belegstellen.
Generation (Erzeugung): Das Sprachmodell formuliert die Antwort auf Basis dieses angereicherten Prompts. Weil die Fakten mitgeliefert wurden, kann es sie zitieren, statt sie zu erraten.
Der Abruf funktioniert über Entitäten und semantische Ähnlichkeit, nicht über Keywords im klassischen Sinn. Genau deshalb spielt strukturierte, eindeutige Information eine so große Rolle für die Auffindbarkeit im Retrieval-Schritt.
Abb. 1: Die RAG-Pipeline – Retrieval, Augmentation und Generation vom Frageeingang bis zur belegten Antwort.
Warum nutzt man RAG gegen Halluzinationen?
RAG löst die zwei größten Schwächen reiner Sprachmodelle: erfundene Fakten und veraltetes Wissen. Ein Sprachmodell erzeugt Text nach statistischer Wahrscheinlichkeit und kann dabei sehr überzeugend klingende, aber falsche Aussagen produzieren – das nennt man Halluzination. Weil RAG die Antwort an konkrete Fundstellen bindet, sinkt dieses Risiko deutlich.
Die wichtigsten Vorteile im Überblick:
Aktualität: Die Wissensbasis lässt sich jederzeit aktualisieren, ohne das Modell neu zu trainieren. Neue Fakten sind sofort verfügbar.
Nachvollziehbarkeit: Antworten können auf ihre Quellen verweisen. Genau das machen KI-Suchen sichtbar, wenn sie Fußnoten oder Links anzeigen.
Fachwissen: Unternehmen binden eigene Dokumente ein – Handbücher, Produktdaten, interne Wikis – ohne diese sensiblen Daten ins Modelltraining zu geben.
Kosten: Der Abruf ist günstiger als ein erneutes Training bei jeder Wissensänderung.
Dieses Verankern einer Antwort an belegbaren Fakten wird auch als Grounding bezeichnet. RAG ist das gängigste technische Verfahren, um Grounding umzusetzen.
Was bedeutet RAG für SEO und GEO?
Für die Suchmaschinenoptimierung bedeutet RAG einen Perspektivwechsel: Inhalte müssen nicht mehr nur ranken, sondern im Retrieval-Schritt als Beleg abrufbar und zitierfähig sein. Systeme wie AI Overviews, ChatGPT oder Perplexity rufen zur Laufzeit Inhalte ab und bauen daraus ihre Antwort. Wer als Quelle abgerufen und genannt werden will, muss für den Retrieval-Schritt optimieren.
Genau hier setzt Generative Engine Optimization (GEO) an – die Disziplin, Inhalte für die Zitierung in KI-Antworten aufzubereiten. Eng verwandt ist LLMO, die Optimierung der Sichtbarkeit in großen Sprachmodellen. Beide zielen darauf, dass ein RAG-System den eigenen Inhalt findet, versteht und als belegte Aussage übernimmt.
Drei Hebel helfen dabei besonders:
Klare Definitionen: Kurze, eigenständig zitierfähige Aussagen – genau wie die Definition am Anfang dieses Artikels – lassen sich leicht als Passage abrufen.
Strukturierte Daten: Schema.org und ein sauberer Knowledge Graph machen Entitäten und Beziehungen maschinenlesbar und erhöhen die Chance, korrekt abgerufen zu werden.
Thematische Tiefe: Vollständig beantwortete Fragen liefern die Passagen, die ein RAG-System als Kontext bevorzugt.
Diese Verzahnung aus technischer Sauberkeit und zitierfähigem Inhalt ist der Kern moderner SEO-Betreuung, die klassische Rankings und KI-Sichtbarkeit gemeinsam denkt.
Wer im Retrieval-Schritt zuverlässig auftauchen will, braucht beides: saubere Technik und zitierfähige Inhalte. Genau darauf zielt GEO (KI-Sichtbarkeit) ab.
RAG vs. reines LLM und Fine-Tuning
RAG, ein reines LLM und Fine-Tuning lösen das Wissensproblem auf unterschiedliche Weise – und schließen sich nicht gegenseitig aus. Ein reines LLM antwortet allein aus dem Trainingswissen. Fine-Tuning trainiert ein Modell mit zusätzlichen Beispielen nach, um Stil oder Fachverhalten zu prägen. RAG dagegen lässt das Modell unangetastet und reicht das Wissen zur Laufzeit an.
Aspekt
Reines LLM
Fine-Tuning
RAG
Wissensstand
eingefroren
eingefroren (bis zum nächsten Training)
jederzeit aktuell
Quellen belegbar
nein
nein
ja
Aufwand bei neuem Wissen
Neutraining
erneutes Fine-Tuning
Wissensbasis updaten
Stärke
flüssige Sprache
Ton & Verhalten
Fakten & Aktualität
In der Praxis werden RAG und Fine-Tuning oft kombiniert: Fine-Tuning prägt, wie das Modell antwortet, RAG steuert bei, womit es antwortet. Für aktuelle, überprüfbare Fakten ist RAG der Ansatz der Wahl.
Abb. 2: RAG im Vergleich zu einem reinen LLM und zum Fine-Tuning – drei Wege, ein Modell mit Wissen zu versorgen.
Häufige Fragen zu Retrieval Augmented Generation
Wofür steht die Abkürzung RAG? RAG steht für Retrieval Augmented Generation, auf Deutsch etwa „abrufgestützte Generierung“. Der Name beschreibt die drei Schritte des Verfahrens: Abruf (Retrieval), Anreicherung (Augmentation) und Erzeugung (Generation).
Braucht RAG eine Vektordatenbank? In den meisten Fällen ja. Eine Vektordatenbank speichert Inhalte als Embeddings und findet im Retrieval-Schritt die semantisch passenden Passagen. Es gibt auch RAG-Varianten mit klassischer Volltextsuche, doch die semantische Suche über Vektoren ist der Standard.
Verhindert RAG Halluzinationen vollständig? Nein. RAG senkt das Risiko deutlich, weil die Antwort an abgerufene Fakten gebunden ist. Falsch oder unvollständig abgerufener Kontext kann aber weiterhin zu Fehlern führen. Qualität und Aktualität der Wissensbasis bleiben entscheidend.
Was hat RAG mit SEO zu tun? KI-Suchsysteme nutzen RAG, um Antworten aus abgerufenen Webinhalten zu bauen. Wer als Quelle zitiert werden möchte, optimiert seine Inhalte so, dass sie im Retrieval-Schritt gefunden und übernommen werden – das ist das Ziel von GEO und LLMO.
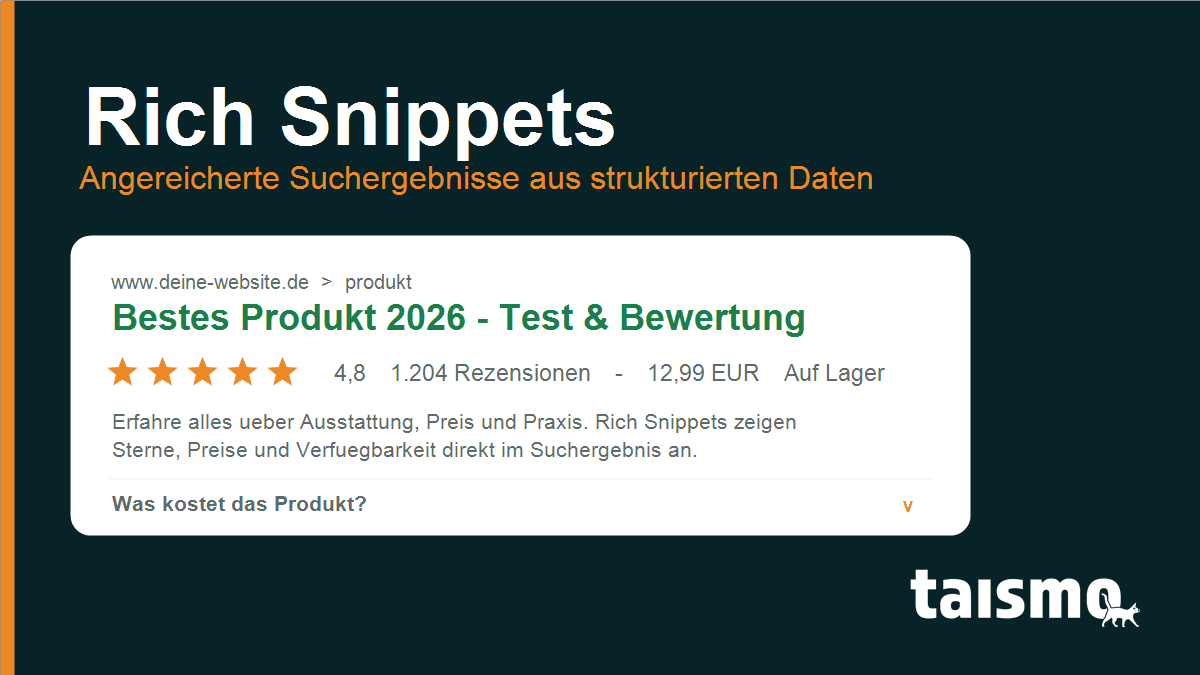
Rich Snippets sind mit Zusatzinformationen angereicherte Suchergebnisse bei Google: Sterne-Bewertungen, Preise, Breadcrumb-Pfade oder Rezept-Daten. Google erzeugt sie aus strukturierten Daten, die eine Website nach dem Vokabular von schema.org im Quelltext hinterlegt. Ein Rich Snippet ersetzt das klassische, reine Text-Ergebnis nicht, sondern ergänzt es um visuelle Extra-Elemente, die direkt in der Trefferliste sichtbar sind.
Der Begriff stammt vom englischen snippet („Schnipsel“) – gemeint ist der einzelne Eintrag in der Trefferliste aus Titel, URL und Beschreibung. „Rich“ macht daraus ein reichhaltiges Ergebnis: Es zeigt auf einen Blick mehr als die Konkurrenz, zieht das Auge auf sich und beantwortet erste Fragen schon vor dem Klick. Für die Suchmaschinenoptimierung sind Rich Snippets deshalb ein starker Hebel für mehr Klicks bei gleicher Position.
Kurzprofil des Begriffs
Merkmal
Angabe
Wortart
Substantiv (Plural, englischer Fachbegriff): das Rich Snippet, die Rich Snippets
strukturierte Daten nach schema.org (meist als JSON-LD)
Verwandte Begriffe
Rich Result, Featured Snippet, SERP, strukturierte Daten, JSON-LD
Wie entstehen Rich Snippets?
Rich Snippets entstehen aus strukturierten Daten, die eine Website maschinenlesbar im Quelltext hinterlegt. Diese Daten beschreiben den Inhalt einer Seite in einem festen Vokabular: „Das hier ist ein Produkt, es kostet 12,99 Euro, hat eine Bewertung von 4,8 aus 1.204 Rezensionen.“ Google liest diese Auszeichnung aus, prüft sie und darf – muss aber nicht – daraus ein Rich Snippet bauen.
Das Vokabular dafür kommt von schema.org, einem gemeinsamen Standard von Google, Bing, Yahoo und Yandex. Die technisch von Google empfohlene Schreibweise ist JSON-LD – ein kompakter Datenblock, der im <head> der Seite liegt und den sichtbaren Text nicht verändert. Ein stark vereinfachtes Beispiel für eine Produktbewertung:
Wichtig: Strukturierte Daten sind nur die Eintrittskarte, keine Garantie. Google entscheidet pro Suchanfrage neu, ob ein Rich Snippet angezeigt wird. Voraussetzung ist immer, dass die ausgezeichneten Daten auch sichtbar auf der Seite stehen. Wer eine Bewertung im Markup behauptet, die auf der Seite nirgends erscheint, riskiert eine manuelle Maßnahme wegen Spam.
Abb. 1: Der Weg vom Seiteninhalt über strukturierte Daten zum fertigen Rich Snippet in der Trefferliste.
Welche Typen von Rich Snippets gibt es?
Es gibt viele Typen von Rich Snippets, weil jeder Inhaltstyp ein eigenes schema.org-Schema besitzt. Google unterstützt und dokumentiert eine feste Liste sogenannter „Structured Data Features“. Die in der Praxis wichtigsten:
Bewertungen (Sterne): Aus AggregateRating – die goldenen Sterne bei Produkten, Rezepten oder lokalen Anbietern. Der auffälligste und begehrteste Typ.
Produkte: Preis, Verfügbarkeit und Bewertung direkt im Ergebnis, ausgezeichnet über das Product-Schema.
FAQ: Frage-Antwort-Paare über das FAQPage-Schema. Google hat die Anzeige 2023 auf Behörden- und Gesundheitsseiten beschränkt und am 7. Mai 2026 ganz eingestellt. Als Rich Snippet erscheint sie nicht mehr, für KI-Systeme bleibt die Auszeichnung sinnvoll.
Rezepte: Kochzeit, Kalorien und ein Vorschaubild über das Recipe-Schema.
Breadcrumbs: Der Pfad der Seite statt der nackten URL, ausgezeichnet über BreadcrumbList.
Veranstaltungen, Videos, Jobs, Bücher: jeweils mit passenden Zusatzangaben wie Datum, Laufzeit oder Gehaltsspanne.
Welche Typen aktuell verfügbar sind, ändert sich laufend – Google baut Formate aus, testet neue und stellt andere wieder ein. Ein Blick in die offizielle Google-Dokumentation vor der Umsetzung lohnt sich deshalb immer.
Rich Snippet, Rich Result oder Featured Snippet?
Diese drei Begriffe werden oft verwechselt, meinen aber Verschiedenes. Der Unterschied liegt darin, woher das Element kommt und wo es in den SERPs steht.
Rich Snippet: Ein normales Suchergebnis, das durch strukturierte Daten um Extra-Elemente wie Sterne oder Preise erweitert ist. Es bleibt an seiner regulären Ranking-Position.
Rich Result: Der neuere, breitere Oberbegriff von Google. Er umfasst Rich Snippets, aber auch aufwändigere Darstellungen wie Karussells oder Bildergalerien. Google selbst spricht heute meist von „Rich Results“; „Rich Snippet“ ist der etablierte, engere Klassiker.
Featured Snippet: Die hervorgehobene Antwortbox ganz oben, oft „Position 0″ genannt. Sie zitiert einen Textausschnitt einer Seite als direkte Antwort und entsteht nicht aus strukturierten Daten, sondern aus Googles Textverständnis.
Kurz gesagt: Rich Snippets steuerst du aktiv über Markup, ein Featured Snippet gewinnst du über guten, klar strukturierten Inhalt. Das Rich Result ist der Sammelbegriff, unter dem Google beide visuellen Aufwertungen zusammenfasst.
Abb. 2: Rich Snippet, Rich Result und Featured Snippet – gleiche Bühne, unterschiedliche Herkunft.
Wie bekommt man Rich Snippets?
Rich Snippets bekommt man, indem man den Seiteninhalt korrekt mit strukturierten Daten auszeichnet und die Auszeichnung anschließend prüft. Der Weg dorthin folgt vier Schritten:
Passenden Typ wählen: Zu jedem Inhalt gehört ein Schema – Product für Shops, Recipe für Rezepte, Article für Beiträge, LocalBusiness für Standorte. Nur das auszeichnen, was auch wirklich auf der Seite steht.
JSON-LD einbauen: Den Datenblock in den <head> setzen. In WordPress übernehmen das SEO-Plugins wie Yoast oder ein eigener Schema-Block; im Shop liefern viele Systeme das Markup automatisch.
Testen: Mit dem Test für Rich-Suchergebnisse (Rich Results Test) von Google prüfen, ob der Typ erkannt wird und keine Fehler oder Warnungen anstehen.
Überwachen: In der Google Search Console zeigt der Bericht zu den erweiterten Suchergebnissen, welche Typen Google gültig eingelesen hat und wo Probleme auftauchen.
Sauber umgesetzte strukturierte Daten sind einer der wirkungsvollsten Hebel der technischen Suchmaschinenoptimierung: Sie kosten nur einmal Aufwand und verbessern dauerhaft die Sichtbarkeit in der Trefferliste. Wer diesen Hebel systematisch nutzen und die richtigen Schema-Typen für jede Seite bestimmen will, ist mit einer strukturierten SEO-Betreuung gut aufgehoben – dort gehören strukturierte Daten und Rich Snippets zum Standardrepertoire.
Dasselbe Markup zahlt über die Suchergebnisse hinaus ein: Eindeutig ausgezeichnete Fakten sind die Grundlage für GEO (KI-Sichtbarkeit), weil KI-Systeme bevorzugt auf maschinenlesbar belegte Angaben zurückgreifen.
Häufige Fragen zu Rich Snippets
Sind Rich Snippets ein Rankingfaktor? Nein, Rich Snippets verbessern die Position in den Suchergebnissen nicht direkt. Sie machen ein Ergebnis aber auffälliger und steigern dadurch die Klickrate – und eine höhere Klickrate kann sich indirekt positiv auf die Sichtbarkeit auswirken.
Garantiert strukturiertes Markup ein Rich Snippet? Nein. Korrektes Markup ist die Voraussetzung, aber Google entscheidet für jede Suchanfrage neu, ob und welches Rich Snippet angezeigt wird. Fehlerfreie, sichtbare und relevante Daten erhöhen die Chance deutlich.
Brauche ich Programmierkenntnisse für Rich Snippets? Nicht zwingend. Für Standardfälle liefern CMS- und Shop-Systeme oder SEO-Plugins das Markup automatisch. Bei individuellen Anforderungen oder komplexen Schema-Kombinationen ist technisches Wissen jedoch hilfreich.
Ein RSS-Feed (Really Simple Syndication) ist ein Format, das zurVerbreitung neuer Inhalte auf Webseitenverwendet wird. Es ermöglicht Nutzern, automatisch die neuesten Updates von ihren bevorzugten Websites zu erhalten, ohne sie direkt besuchen zu müssen. Ein RSS-Feed enthält in der RegelTitel,KurzbeschreibungenundLinkszu vollständigen Artikeln oder Beiträgen.
Wie funktioniert ein RSS Feed?
RSS-Feeds werden inXML-Dateien (eXtensible Markup Language) strukturiert, die leicht von Computern gelesen werden können. Nutzer abonnieren den RSS-Feed einer Webseite mit einem RSS-Feed-Reader, einer speziellen Software oder App, die RSS-Feeds lesen kann. Sobald eine Webseite neue Inhalte veröffentlicht, aktualisiert sie ihren RSS-Feed, und derFeed-Readerzeigt diese neuen Inhalte automatisch an, sodass der Nutzer sie sofort sehen kann.
Ist die Technik hinter RSS Feeds veraltet?
Obwohl RSS-Feeds als etwasveraltet gelten, insbesondere im Vergleich zu moderneren Technologien wie sozialen Medien und Push-Benachrichtigungen, bieten sie immer noch spezifischeVorteile. RSS-Feeds sind besonders nützlich für diejenigen, die einegroßeMengevon Inhalten verfolgen möchten,ohnedurchWerbungoder algorithmisch kuratierte Feeds gestört zu werden.
Wo werden RSS Feeds im Marketing noch eingesetzt?
Im Marketing werden RSS-Feeds verwendet, umregelmäßigInhaltezu verbreiten und die Sichtbarkeit von Webseiten zu erhöhen. Sie sind hilfreich fürContent-Marketingund können in E-Mail-Newslettern, auf Webseiten und insozialen Medienintegriert werden, um sicherzustellen, dass die neuesten Beiträge oder Angebote sofort von einem breiten Publikum wahrgenommen werden. RSS-Feeds werden auch häufig inautomatisiertenMarketingstrategienverwendet, um Inhaltedynamischauf verschiedenen Plattformen zu aktualisieren.
Die robots.txt ist eine Textdatei, auf einem Webserver. Sie ist nach dem Robots-Exclusion-Standard-Protokoll aufgebaut ist. Sie enthält Anweisungen an einen Web-Crawler, welcher die Seite scannt, um sie für eine Suchmaschine zu indexieren.
Sind Suchmaschinenbetreiber verpflichtet die Anweisungen der robots.txt-Datei zu befolgen?
Nein! Bei den Informationen in der robots.txt-Datei handelt es lediglich sich um eine Leseempfehlung des Website-Betreibers an die Suchmaschine. Große Suchmaschinen wie Google, Bing oder Yahoo einigten sich 2008 darauf, die Anweisungen der robots.txt zu befolgen. Eine hundertprozentige Garantie gibt es jedoch nie.
Wo muss ich die robots.txt-Datei auf meinem Webserver ablegen?
Die Datei muss im Stammverzeichnis, also dem obersten Verzeichnis, des Webservers liegen. Die Datei ist also stets erreichbar, fügt man der URL nach der Top Level Domain ein /robots.txt hinzu.
Beispiel: https://taismo.de/robots.txt
Wie ist eine robots.txt-Datei aufgebaut?
Die Syntax ist sehr überschaubar aufgebaut und besteht aus drei grundlegenden Elementen:
User-agent:
Dieses Element legt fest, für welchen Bot die folgenden Anweisungen gelten sollen.
Beispiel: googlebot
Soll die Anweisung für alle Bots gelten, kann ich * eingefügt werden.
Beispiel: User-agent: *
Allow:
Das Element gibt ein Verzeichnis oder eine bestimmte Seite an, die gecrawled werden soll.
Disallow:
Das Element gibt ein Verzeichnis oder eine bestimmte Seite an, die nichtgecrawled werden soll.
Dieser Codeschnipsel enthält Anweisungen für alle Crawler. Diese sollen die Ordner wp-admin nicht durchsuchen mit Ausnahme der PHP-Datei admin-ajax.php.
Welchen Einfluss hat die robots.txt-Datei auf SEO?
Eine falsch angelegte robots.txt-Datei kann dazu führen, dass bestimmte Inhalte Ihres Webauftritts nicht auf der SERP angezeigt werden, da sie vom Crawling ausgeschlossen sind. Ranken bestimmte Seiten nicht wie gewünscht, sollten die Anweisungen in der Datei untersucht werden.
Mit der robots.txt-Datei können weitere SEO relevanten Informationen an den Web-Crawler überliefert werden. Unter anderem kann der Pfad zur Sitemap hinterlegt werden.
Wie das geht, können Sie in unserem Glossar Beitrag zur Sitemap nachlesen.
Passt sich die Gestaltung einer Website automatisch an das verwendete Endgerät und dessen Bildschirmgröße sowie –Auflösung an, spricht man von einem responsiven Design oder auch responsive Webdesign.
Welche Vorteile bietet responsive Design?
Über 50 Prozent aller weltweiten Seitenaufrufe im Jahr 2020 wurden von einem Smartphone getätigt. Aufgrund des hohen Anteils mobiler Geräte tragen responsive Webseiten massiv zu einer positiven Nutzererfahrung bei. Alternativ zu einem responsive Webdesign könnte ebenfalls eine eigene, mobile Website angelegt werden. Häufig ist der Aufwand zur Website Pflege in diesem Fall jedoch höher, da die verschiedenen Versionen der Seite häufig getrennt voneinander auf dem neuesten Stand gehalten werden müssen.
Neben diesen beiden Punkten, ist eine gute Darstellung einer Internetseite auf einem mobilen Gerät bereits seit 2015 Rankingfaktor für Google.
Welche Rolle spielt responsives Webdesign für SEO?
Seit die Suchmaschine Google im März 2021 seine Indexierung von “Mobile First” zu “Mobile Only” geändert hat, ist responsive Design für SEO relevanter denn je. Webseiten, die lediglich in einer für den Desktop angepassten Version existieren, werden von der Suchmaschine nicht mehr gelistet. Somit ist eine an alle Geräte angepasste Website aus dem modernen Internet nicht mehr wegzudenken.
Du brauchst Hilfe, um auf deiner Website einen responsive Check durchzuführen?
Sie sehen gerade einen Platzhalterinhalt von Hubspot Embedded Content. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Sie sehen gerade einen Platzhalterinhalt von HubSpot. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Sie sehen gerade einen Platzhalterinhalt von Hubspot Meetings. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.