Strukturierte Daten prüfen: So testest du Schema-Markup und KI-Lesbarkeit
Dominik ist Gründer und Geschäftsführer von taismo und seit über zehn Jahren auf SEO-Betreuung und Sichtbarkeit in KI-Antworten (GEO) spezialisiert. Mit seinem Team betreut er Unternehmen aus dem Münchner Raum und ganz Deutschland.
🔄 Zuletzt aktualisiert: 09.10.2026
Strukturierte Daten prüfst du mit vier Werkzeugen, die jeweils eine andere Frage beantworten: Der Rich-Results-Test von Google zeigt, welche Rich Results deine Seite auslösen kann. Der Schema Markup Validator prüft Syntax und das gesamte schema.org-Vokabular. Die Search Console meldet Fehler auf der ganzen Website. Eine Browser-Erweiterung zeigt den Schema-Graphen direkt im geöffneten Tab, auch auf Seiten hinter einem Login. Für KI-Systeme zählt zusätzlich, ob das Markup ohne JavaScript im ausgelieferten HTML steht und zum sichtbaren Text passt.
👉 Du willst wissen, wie gut deine ganze Website für Google und KI-Systeme lesbar ist? Mach den kostenlosen GEO-Check
Transparenz: Dieser Leitfaden erscheint im SEO-Magazin von taismo, der SEO- und GEO-Agentur aus München. Eines der vorgestellten Werkzeuge, der GEO & Schema Checker, stammt von uns. Deshalb belegen wir jede Aussage über die Werkzeuge mit Quelle und Stichtag.
Strukturierte Daten prüfen: Fünf Fragen, fünf Prüfebenen
Strukturierte Daten sind maschinenlesbare Angaben im Quelltext einer Seite. Sie sagen Suchmaschinen und KI-Systemen ausdrücklich, was die Seite enthält, etwa einen Artikel, ein Produkt, eine Veranstaltung, ein Unternehmen oder eine Person. Das Vokabular dafür liefert Schema.org, ein gemeinsames Projekt von Google, Microsoft, Yahoo und Yandex. Es umfasst in Version 30.1 vom September 2026 826 Typen und 1.540 Eigenschaften. Als Format empfiehlt Google JSON-LD; Microdata und RDFa unterstützt Google ebenfalls.
Eine vollständige Prüfung beantwortet fünf Fragen, und jede Frage braucht ein eigenes Werkzeug:
- Syntax: Ist der Code fehlerfrei lesbar, also gültiges JSON-LD, Microdata oder RDFa?
- Vokabular: Existieren die verwendeten Typen und Eigenschaften in schema.org?
- Google-Eignung: Enthält das Markup alle Pflichtangaben für ein Rich Result in der Google-Suche?
- Zusammenhang: Hängen die Knoten über ihre
@idzu einem Graphen zusammen, und stimmt das Markup mit dem sichtbaren Inhalt überein? - KI-Lesbarkeit: Dürfen Suchmaschinen und KI-Systeme die Seite abrufen, und steht das Markup ohne JavaScript im ausgelieferten HTML?
Die Fragen 1 bis 3 beantworten die bekannten Testtools zuverlässig. Für die Fragen 4 und 5 brauchst du den Blick auf die ganze Seite. Google schreibt in seinen allgemeinen Richtlinien selbst, dass die Qualitätsrichtlinien für strukturierte Daten „mit einem automatisierten Tool nicht leicht getestet werden“ können. Dazu gehört die wichtigste Regel: Das Markup beschreibt nur, was Besucher auf der Seite auch sehen.
Der Rich-Results-Test zeigt, welche Rich Results Google erkennt
Der Test für Rich-Suchergebnisse ist Googles eigenes Prüfwerkzeug für strukturierte Daten. Du gibst eine URL oder ein Code-Snippet ein, und Google zeigt dir, welche Rich-Result-Typen es auf der Seite gefunden hat, ob sie gültig sind und welche Fehler oder Warnungen bestehen. Google empfiehlt, jede Prüfung mit diesem Test zu beginnen und danach den Schema Markup Validator für die allgemeine Prüfung zu nutzen.
Was der Rich-Results-Test anzeigt
- Erkannte Rich Results: Etwa Artikel, Produkt-Snippets, Brotkrumen, Veranstaltungen oder Rezepte, jeweils mit dem Status gültig oder ungültig.
- Fehler und Warnungen: Ein Fehler betrifft eine Pflichtangabe und schließt das Rich Result aus. Eine Warnung betrifft eine empfohlene Angabe; das Rich Result bleibt möglich.
- Gerenderte Seite: Der Test lädt die Seite standardmäßig mit dem Smartphone-Crawler von Google, führt JavaScript aus und wertet den gerenderten HTML-Code aus.
- Vorschau: Für einige Typen zeigt der Test, wie das Ergebnis in der Google-Suche aussehen kann.
Wofür der Rich-Results-Test gedacht ist
Der Rich-Results-Test beantwortet eine Frage sehr genau: Kann Google aus diesem Markup ein Rich Result erzeugen? Daraus folgen drei Eigenschaften, die du beim Lesen der Ergebnisse kennen solltest:
- Google-Typen im Fokus: Der Test erkennt die Rich-Result-Typen, die Google in der Suche unterstützt. Ein korrektes
DefinedTerm-Markup für ein Glossar taucht dort nicht als eigenes Element auf. - Öffentliche Seiten: Alle Ressourcen der Seite müssen für einen anonymen Nutzer erreichbar sein. Seiten hinter einem Login und Seiten, die die robots.txt sperrt, prüfst du deshalb über den Code-Reiter.
- Kein Anzeigeversprechen: Google garantiert keine Anzeige, auch wenn der Test das Markup als gültig einstuft.
Außerdem kürzt Google die Liste der Rich Results regelmäßig. Seit August 2023 zeigt Google FAQ-Rich-Results nur noch für bekannte, verlässliche Behörden- und Gesundheitswebsites; die Anleitungs-Ergebnisse sind seit September 2023 ganz verschwunden. Im Juni 2025 hat Google sieben weitere Darstellungen eingestellt, darunter Kursinformationen, Faktenprüfungen und geschätzte Gehälter. Google betont dabei, dass nicht verwendete strukturierte Daten „keine Probleme für die Google Suche“ darstellen und dass ihre Nutzung außerhalb der Google-Suche unberührt bleibt. Ein fehlendes Rich Result ist deshalb kein Beweis für fehlerhaftes Markup. Was Rich Results im Suchergebnis leisten, erklärt unser Glossar zu Rich Snippets.
Entwürfe prüfst du, bevor sie online sind: Öffne die Vorschau im Browser, kopier den Quelltext und füge ihn im Rich-Results-Test unter „Code“ ein. Fügt deine Seite das JSON-LD erst per JavaScript ein, kopierst du das gerenderte HTML aus den Entwicklertools deines Browsers.
Der Schema Markup Validator prüft das gesamte schema.org-Vokabular
Der Schema Markup Validator unter validator.schema.org prüft, ob strukturierte Daten syntaktisch korrekt sind und den Regeln von schema.org entsprechen. Er arbeitet mit allen Typen des Vokabulars und gibt keine Google-spezifischen Warnungen aus. Du prüfst eine URL oder Code; das Ergebnis listet jedes erkannte Element mit allen Eigenschaften.
Der Validator ist der Nachfolger des früheren Testtools von Google
Bis 2021 gab es Googles „Testtool für strukturierte Daten“. Am 15. Dezember 2020 kündigte Google an, das Werkzeug an die schema.org-Community zu übergeben und auf Syntax und schema.org-Konformität auszurichten. Seit Mai 2021 läuft es als Schema Markup Validator unter eigener Domain, und seit August 2021 leitet die alte Adresse auf eine Auswahlseite weiter. Seitdem gilt eine klare Arbeitsteilung: Der Rich-Results-Test prüft Googles Rich Results, der Validator prüft das Vokabular. Anleitungen aus der Zeit vor 2021 nennen deshalb noch das alte Werkzeug.
Wann der Validator die bessere Wahl ist
Der Validator ist das richtige Werkzeug für alle Typen, die Google nicht als Rich Result ausspielt. Google nennt selbst das Beispiel ExercisePlan. In der Praxis betrifft das vier Fälle:
- Entitäts-Markup: Organisation mit Profilen, Kennungen und Gründer, Person mit Qualifikation und Arbeitgeber
- Fachbegriffe:
DefinedTermundDefinedTermSetfür Glossare und Wissensdatenbanken - Werke und Software:
Book,SoftwareApplicationundCreativeWork - Eingestellte Rich Results: Etwa Kursinformationen oder Faktenprüfungen, deren Nutzung außerhalb der Google-Suche laut Google unberührt bleibt
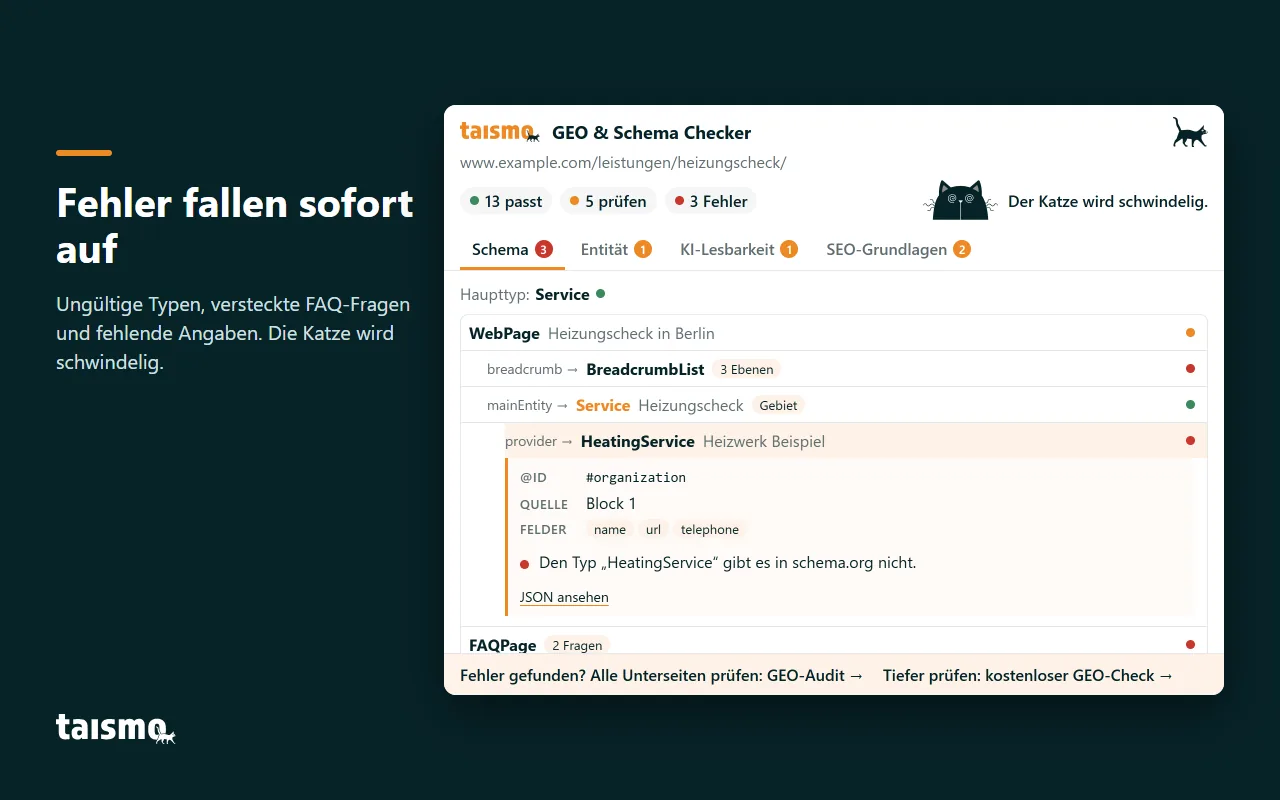
Wir haben den Validator am 7. Oktober 2026 an einer Testseite gegengeprüft. Ein erfundener Typ wie HeatingService erscheint dort als Fehler „ungültiger Typ“. Ob Google ein Rich Result anzeigt, prüfst du anschließend im Rich-Results-Test; ob Markup und sichtbarer Text übereinstimmen, prüfst du im Abgleich mit der Seite selbst.
Die Search Console zeigt Fehler auf der ganzen Website
Die Google Search Console zeigt, wie Google die strukturierten Daten deiner Website tatsächlich verarbeitet hat. Unter „Verbesserungen“ gibt es für jeden Rich-Result-Typ, den Google auf deiner Website findet, einen eigenen Bericht mit gültigen und ungültigen Elementen im Zeitverlauf. Berichte zu Produkt-Snippets und Händlereinträgen stehen unter „Shopping“.
Drei Details helfen beim Lesen der Berichte:
- Elemente, keine Seiten: Die Zahlen zählen Elemente. Eine Seite mit drei Produkten liefert drei Elemente.
- Stichprobe: Die Berichte enthalten eine Stichprobe der erkannten Elemente, und die Beispieltabelle ist auf 1.000 Zeilen begrenzt.
- Erst nach dem Crawl: Ein Fehler erscheint, sobald Google die Seite neu gecrawlt hat. Nach einer Korrektur startest du über die Überprüfung der Fehlerbehebung eine erneute Prüfung.
Das URL-Prüftool vergleicht indexierte und aktuelle Fassung
Für einzelne URLs ist das URL-Prüftool der Search Console das genaueste Werkzeug. Es zeigt zwei Fassungen. Die indexierte Version enthält alle Verbesserungen, die Google bei der letzten Indexierung gefunden hat; „Live-URL testen“ zeigt den aktuellen Stand. Unter „Getestete Seite anzeigen“ siehst du den gerenderten HTML-Code, einen Screenshot, die HTTP-Header und die Ausgabe der JavaScript-Konsole. So erkennst du, ob ein per JavaScript eingefügtes Markup bei Google ankommt.
Die Search Console zeigt nur Websites, deren Inhaberschaft du bestätigt hast; fremde Seiten prüfst du mit den Testtools oder einer Browser-Erweiterung.
Browser-Erweiterungen prüfen strukturierte Daten direkt im geöffneten Tab
Eine Browser-Erweiterung liest die Seite in deinem eigenen Browser, so wie du sie gerade siehst, mit deiner Anmeldung und nach dem Ausführen von JavaScript. Deshalb funktioniert sie auf Staging-Systemen, in Vorschauen unveröffentlichter Seiten, im Intranet und hinter einem Login. Ein Klick genügt, und du musst keine URL kopieren.
Im Chrome Web Store gibt es vier Arten von Schema-Erweiterungen. Die Nutzerzahlen stammen aus dem Store, Stand 7. Oktober 2026:
| Art | Beispiel | Was die Erweiterung macht |
|---|---|---|
| Weiterleitung an Google | „Rich Results: Structured Data Test Plugin“, rund 5.000 Nutzer | schickt die geöffnete URL mit einem Klick an den Rich-Results-Test |
| Anzeige und Prüfung | „Fast Schema Markup Checker“ von Vryse, rund 10.000 Nutzer | findet das Schema-Markup der Seite und validiert es |
| Visualisierung | „SEO Schema Visualizer“, rund 8.000 Nutzer | stellt JSON-LD als interaktiven Graphen dar |
| Erstellung | „Schema Builder for Structured Data“ von Schema.dev, rund 40.000 Nutzer | erstellt JSON-LD per Klick und Formular |
Welche Erweiterung passt, hängt von deiner Aufgabe ab. Wer Markup erstellt, braucht einen Builder. Wer prüfen will, was eine Seite ausliefert, wie ihre Knoten zusammenhängen und ob KI-Systeme sie lesen können, braucht eine Anzeige mit Graph und Seitenabgleich. Für diese Aufgabe haben wir bei taismo den GEO & Schema Checker für Chrome entwickelt, den wir weiter unten vorstellen.
Der Schema-Graph zeigt, wie die Knoten über @id zusammenhängen
Viele Seiten liefern mehr als einen JSON-LD-Block aus. Ein SEO-Plugin erzeugt die Grundangaben zu Seite, Website und Brotkrumen, das Theme ergänzt ein Logo, und ein eigener Block beschreibt Artikel, Autor und Unternehmen. Die @id kennzeichnet nach dem JSON-LD-Standard des W3C einen Knoten eindeutig. Knoten mit derselben @id beschreiben deshalb dieselbe Sache, und Werkzeuge, die den Graphen auswerten, führen sie zu einem Knoten zusammen.
Verweise entstehen, indem ein Knoten nur die @id eines anderen nennt. Im folgenden Ausschnitt verweist der Artikel auf Autorin und Unternehmen, ohne sie neu zu beschreiben:
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "BlogPosting",
      "@id": "https://www.example.com/magazin/waermepumpen-check/#article",
      "headline": "Wärmepumpen-Check: Ablauf, Dauer und Kosten",
      "author": { "@id": "https://www.example.com/#person-lena-muster" },
      "publisher": { "@id": "https://www.example.com/#organization" }
    },
    {
      "@type": "Organization",
      "@id": "https://www.example.com/#organization",
      "name": "Heizwerk Beispiel GmbH"
    }
  ]
}
Der Schema Markup Validator löst solche Verweise auf. In unserer Gegenprobe vom 7. Oktober 2026 hat er zwei Blöcke mit derselben Organisations-@id zu einem Knoten mit Name und Telefonnummer zusammengeführt und den Artikel verschachtelt unter der Seite gezeigt. Verweist ein Knoten auf eine @id, die auf der Seite nirgends beschrieben ist, zeigt der Validator dort ein leeres „Thing“ ohne Fehlermeldung. Ob dahinter ein gewollter Verweis auf eine sitewide Entität steckt oder ein Tippfehler, entscheidest du selbst.
Prüfst du den Graphen, achtest du auf drei Punkte:
- Jeder Verweis findet sein Ziel: Eine
@id, auf die verwiesen wird, steht auf derselben Seite oder ist als sitewide Entität eindeutig beschrieben, etwa das Unternehmen auf der Startseite. - Jede Entität trägt genau eine
@id: Beschreiben drei Blöcke dasselbe Unternehmen mit drei verschiedenen@id-Werten, entstehen im Graphen drei Unternehmen. - Jede Liste hat eine Quelle: Liefern Plugin und eigener Block beide eine
BreadcrumbListunter derselben@id, vermischen sich die Einträge.
Ein sauberer Graph hilft Suchmaschinen und KI-Systemen, eine Seite eindeutig einer Entität zuzuordnen: Artikel, Autor und Unternehmen sind dann ausdrücklich miteinander verbunden. Welche Typen in welchem Fall passen und wie du sie einbaust, zeigt unser Beitrag Schema.org und JSON-LD in der Praxis.
8 typische Fehler beim Prüfen strukturierter Daten
Die meisten Fehler in strukturierten Daten entstehen im Zusammenspiel mehrerer Quellen oder bei späteren Änderungen an der Seite. Die Tabelle zeigt acht typische Fehler, woran du sie erkennst und welches Werkzeug sie aufdeckt:
| Fehler | Woran du ihn erkennst | Welches Werkzeug ihn zeigt |
|---|---|---|
| Erfundener Typ | Ein Typ wie „HeatingService“ steht in keinem schema.org-Verzeichnis | Schema Markup Validator, Browser-Erweiterung |
| Pflichtangabe fehlt | Eine Brotkrumenliste ohne Ziel-URL in einem Zwischenschritt, ein Produkt ohne Namen | Rich-Results-Test, Search Console |
| Unsichtbare FAQ | Fragen stehen im Markup, aber nicht auf der Seite | Abgleich mit der sichtbaren Seite, Browser-Erweiterung mit Seitenabgleich |
| Zwei Quellen, eine Liste | Plugin und eigener Block liefern eine BreadcrumbList unter derselben @id |
Search Console, Graph-Ansicht |
| Entität mehrfach | Das Unternehmen erscheint dreimal mit verschiedenen @id-Werten |
Graph-Ansicht |
| Verweis ins Leere | Eine @id mit Tippfehler zeigt auf einen Knoten, den es nicht gibt |
Graph-Ansicht, Validator (leeres „Thing“) |
| Abweichende Fakten | Telefonnummer, Adresse oder Preis im Markup weichen vom sichtbaren Text ab | Abgleich mit der sichtbaren Seite |
| Markup nur per JavaScript | Das JSON-LD fehlt im Quelltext und erscheint erst nach dem Rendern | Quelltext ohne JavaScript, URL-Prüftool |
Die Fehler „Unsichtbare FAQ“ und „Abweichende Fakten“ wiegen besonders schwer, weil sie gegen die Qualitätsrichtlinien von Google verstoßen. Google schreibt dazu: „Markiere keine für die Leser der Seite nicht sichtbaren Inhalte.“ Ein Verstoß kann zu einer manuellen Maßnahme führen. Die Seite erscheint dann nicht mehr als Rich Result, ihr Ranking in der Websuche bleibt laut Google davon unberührt. Widersprüchliche Angaben machen eine Quelle zudem für Suchmaschinen und KI-Systeme schwerer einzuordnen. Telefonnummer und Adresse gehören deshalb in Schema, Impressum und Profile in identischer Form, so wie es die Regeln für NAP-Daten beschreiben.
KI-Lesbarkeit prüfen: Was KI-Systeme von deiner Seite lesen können
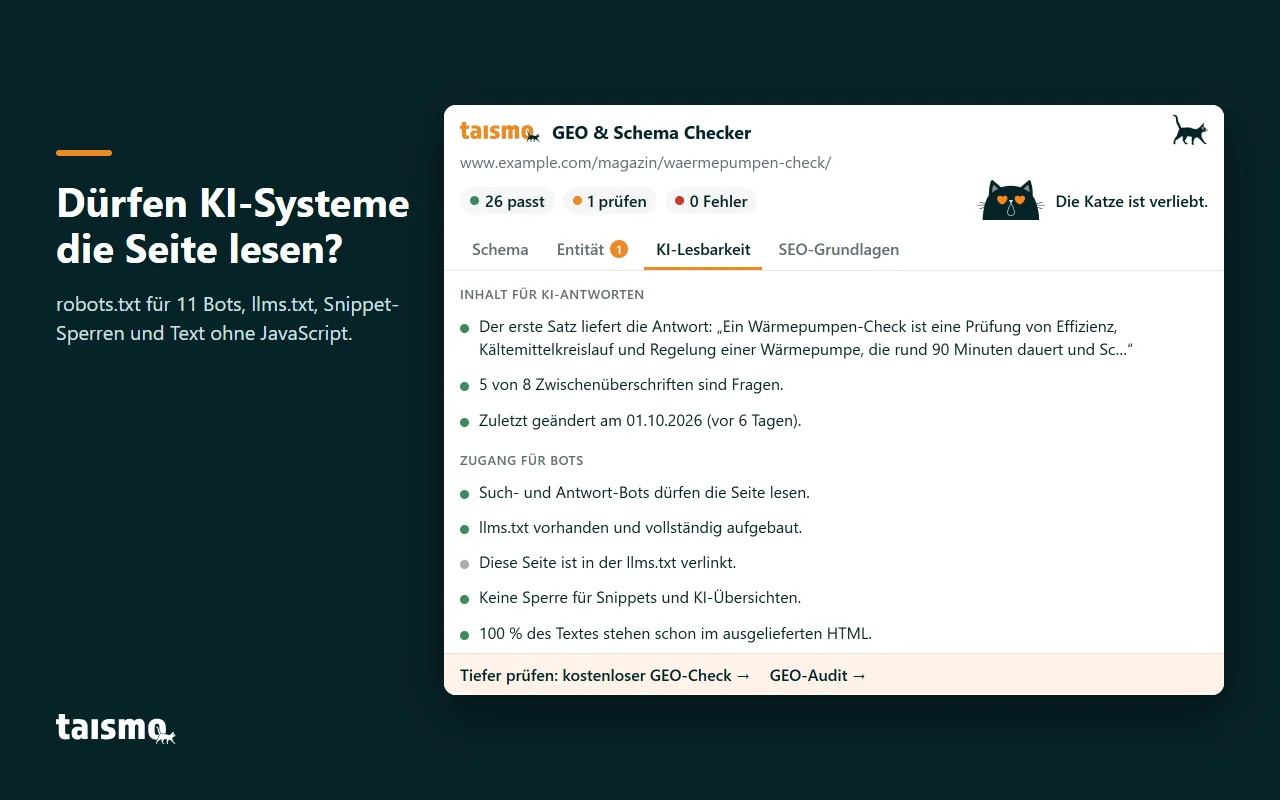
KI-Lesbarkeit beschreibt, ob KI-Systeme eine Seite abrufen, verstehen und als Quelle verwenden können. Für die KI-Funktionen der Google-Suche, also die Übersichten mit KI und den KI-Modus, nennt Google keine zusätzlichen Anforderungen: Eine Seite muss indexiert sein und für ein Snippet infrage kommen. Spezielles schema.org-Markup oder eigene KI-Dateien verlangt Google ausdrücklich nicht. Eine Regel hebt Google aber hervor: „Deine strukturierten Daten müssen mit dem sichtbaren Text auf der Seite übereinstimmen.“
Andere KI-Systeme rufen Seiten mit eigenen Crawlern ab. Eine Analyse von Vercel vom Dezember 2024 kommt zu einem klaren Ergebnis: Keiner der großen KI-Crawler führt JavaScript aus. Das gilt für die Crawler von OpenAI (GPTBot, OAI-SearchBot, ChatGPT-User), Anthropic (ClaudeBot), Meta, ByteDance und Perplexity. Gemini nutzt die Infrastruktur des Googlebot und rendert JavaScript vollständig. Inhalte, die bereits in der ersten HTML-Antwort stehen, darunter JSON-Daten, können KI-Systeme laut Vercel trotzdem auswerten.
Vier Prüfpunkte für die KI-Lesbarkeit
- Markup im ausgelieferten HTML: Ruf den Quelltext auf, in Chrome mit Strg+U, und such nach
application/ld+json. Was dort fehlt und erst nach dem Laden per Tag Manager erscheint, sehen viele KI-Crawler nicht. Google verarbeitet per JavaScript erzeugtes Markup, weist bei Produktdaten aber selbst darauf hin, dass Shopping-Crawls dadurch seltener und weniger zuverlässig laufen können. - Zugang in der robots.txt: Prüf, welche Bots deine robots.txt zulässt. Such-Crawler wie OAI-SearchBot holen Seiten für Antworten ab, Trainings-Crawler wie GPTBot und ClaudeBot sammeln Daten für Modelle, und Google-Extended regelt die Nutzung für Training und Fundierung in Gemini. Wie du sie einzeln steuerst, zeigt unser Ratgeber KI-Crawler steuern.
- Snippet-Sperren: Die Anweisungen
nosnippet,data-nosnippet,max-snippetundnoindexbegrenzen laut Google, welche Informationen einer Seite in der Google-Suche erscheinen, einschließlich der KI-Funktionen. Solche Anweisungen stehen im HTML oder als X-Robots-Tag im HTTP-Header. Eine versehentlich gesetzte Sperre nimmt eine Seite aus den Übersichten mit KI. - llms.txt: Die optionale Datei im Stammverzeichnis fasst KI-Systemen die wichtigsten Inhalte einer Website zusammen. Google braucht sie nach eigener Aussage nicht; ob ein anderes KI-System sie liest, entscheidet der Anbieter. Mehr dazu im Praxis-Guide zur llms.txt.
Auch der Text zählt: Abschnitte, die eine Frage im ersten Satz beantworten, lassen sich leichter als Quelle übernehmen. Wie zitierfähige Inhalte aufgebaut sind, beschreibt unser Beitrag zitierfähiger Content für KI-Antworten, und wie strukturierte Daten, Entität und Inhalte zusammenspielen, zeigt unsere Leistungsseite GEO für Unternehmen.
Der GEO-Audit von taismo prüft Entität, strukturierte Daten und maschinelle Auffindbarkeit deiner ganzen Website und liefert die Maßnahmen in der richtigen Reihenfolge.
Prüfwege im Vergleich: Welches Werkzeug welche Frage beantwortet
Jeder Prüfweg deckt andere Ebenen ab. Die Tabelle ordnet die Werkzeuge den fünf Prüfebenen aus Abbildung 1 zu:
| Werkzeug | Beantwortet | Prüft | Seiten hinter Login | Kosten |
|---|---|---|---|---|
| Rich-Results-Test | Syntax und Google-Eignung (1, 3) | eine URL oder Code | über den Code-Reiter | kostenlos |
| Schema Markup Validator | Syntax und Vokabular (1, 2) | eine URL oder Code | über Code | kostenlos |
| Search Console, Berichte | Google-Eignung nach dem Crawl (3) | die ganze eigene Website als Stichprobe | nein | kostenlos |
| URL-Prüftool | indexierte und aktuelle Fassung (3) | eine URL der eigenen Website | nein | kostenlos |
| Browser-Erweiterungen | je nach Erweiterung (1, 2, 4) | die geöffnete Seite | ja | meist kostenlos |
| GEO & Schema Checker | Syntax, Typen, Graph, Entität und KI-Lesbarkeit (1, 2, 4, 5) | die geöffnete Seite | ja | kostenlos |
Kurz gesagt: Für Googles Rich Results ist der Rich-Results-Test maßgeblich, für das Vokabular der Validator und für die ganze Website die Search Console. Eine Browser-Erweiterung ergänzt den Blick auf eine einzelne Seite im Zusammenhang, auch vor dem Livegang.
Der GEO & Schema Checker zeigt Schema, Entität und KI-Lesbarkeit mit einem Klick
Der GEO & Schema Checker ist eine kostenlose Chrome-Erweiterung von taismo. Sie prüft die geöffnete Seite in vier Reitern und bewertet jeden Befund mit einer Ampel in drei Stufen, von „passt“ über „prüfen“ bis „Fehler“.
- Schema: Alle JSON-LD-Blöcke als Baum, über die
@idzusammengeführt, mit Haupttyp und Bewertung je Knoten. - Entität: Organisation und Autor, Verweise auf Wissensdatenbanken wie Wikidata, Kennungen und Profile sowie der Abgleich von Name, Telefonnummer und Adresse zwischen Schema und Seite.
- KI-Lesbarkeit: Antwort im ersten Satz, Frage-Überschriften, Aktualität, robots.txt für 11 Such- und KI-Bots, llms.txt, Snippet-Sperren und Text ohne JavaScript.
- SEO-Grundlagen: Title, Description, Canonical, Indexierbarkeit, Open Graph, Sitemap, hreflang und alle Überschriften von H1 bis H6.
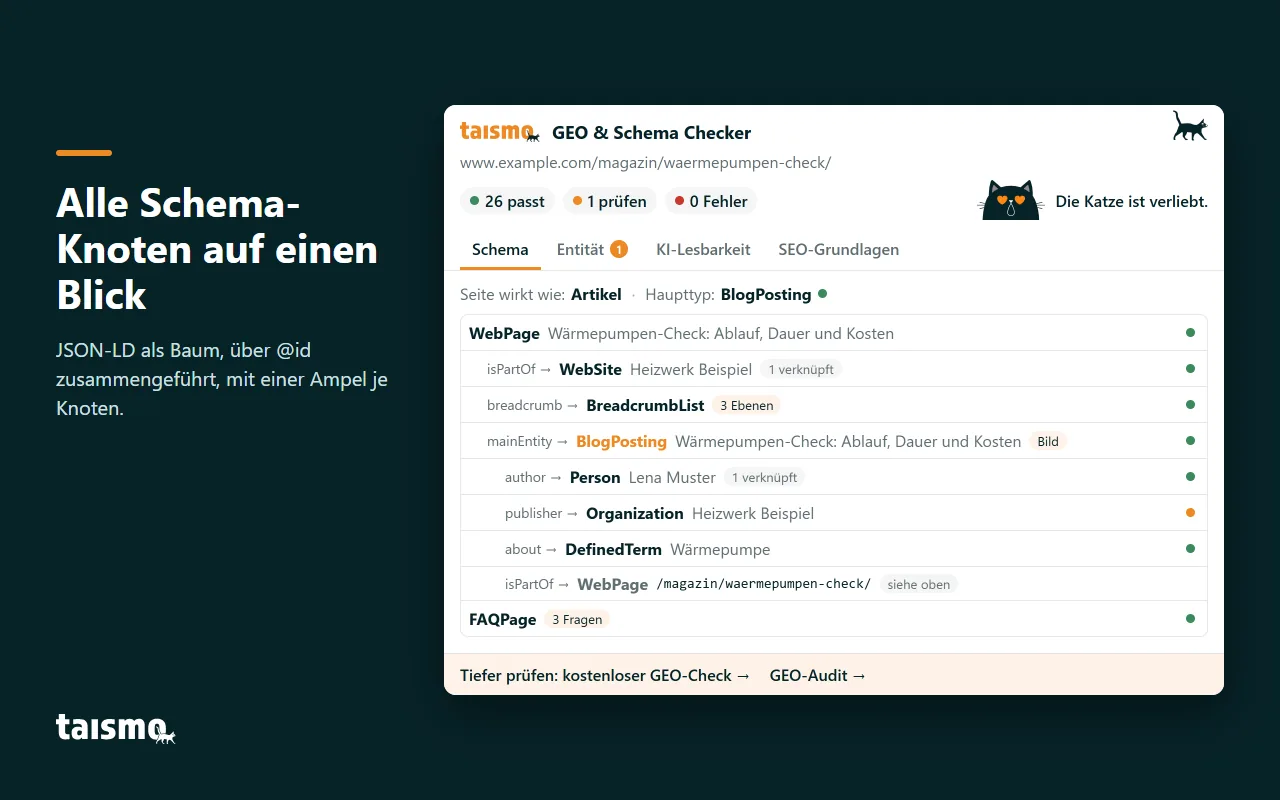
Die Prüfung läuft vollständig in deinem Browser. Die Erweiterung sendet keine Daten an taismo oder an Dritte, braucht kein Konto und greift nur auf den Tab zu, den du gerade prüfst. Abgerufen werden nur Dateien der geprüften Website, etwa ihre robots.txt und llms.txt. Deshalb funktioniert sie auch auf Seiten hinter einem Login und in Vorschauen, die noch nicht veröffentlicht sind. Für die Detailprüfung führt jeder Knoten per Link direkt in den Rich-Results-Test und in den Schema Markup Validator.
Den Checker installierst du kostenlos im Chrome Web Store. Er läuft auch in anderen Browsern, die Chrome-Erweiterungen installieren können, etwa Microsoft Edge und Brave. Er prüft immer die Seite, die gerade offen ist; wie gut deine gesamte Website für Suchmaschinen und KI-Systeme lesbar ist, zeigt der kostenlose GEO-Check. Wir haben den Checker für unsere eigene Arbeit gebaut, denn taismo setzt als SEO- und GEO-Agentur aus München strukturierte Daten und KI-Sichtbarkeit für Unternehmen um.
Prüfroutine in 6 Schritten: So prüfst du strukturierte Daten vollständig
Die Werkzeuge entfalten ihren Wert in der richtigen Reihenfolge. Diese Routine deckt alle fünf Prüfebenen ab:
- Schritt 1: Vorschau prüfen. Prüf die Seite vor dem Livegang mit einer Browser-Erweiterung oder kopier den Quelltext in den Code-Reiter des Rich-Results-Tests.
- Schritt 2: Rich Results testen. Prüf nach dem Livegang die URL im Rich-Results-Test und behebe Fehler bei Pflichtangaben sofort.
- Schritt 3: Vokabular validieren. Prüf Typen ohne Rich Result, etwa Organisation, Person oder Glossarbegriffe, im Schema Markup Validator.
- Schritt 4: Graph und Seite abgleichen. Prüf, ob jeder
@id-Verweis ein Ziel hat, jede Entität genau eine@idträgt und FAQ, Preise, Telefonnummer und Adresse im Markup mit dem sichtbaren Text übereinstimmen. - Schritt 5: KI-Lesbarkeit prüfen. Kontrollier den Quelltext ohne JavaScript, die robots.txt und die Snippet-Sperren.
- Schritt 6: Search Console beobachten. Sieh dir die Berichte unter „Verbesserungen“ einmal im Monat an und starte nach jeder Korrektur die Überprüfung der Fehlerbehebung.
Wiederhol die Schritte 2 bis 5 nach jedem Update von Theme, SEO-Plugin oder Seitenvorlage, denn ein einziges Update kann das Markup aller Seiten eines Typs verändern. Bei einem Umzug gehört die Prüfung strukturierter Daten auf die Checkliste für den Website-Relaunch, vor und nach dem Wechsel. Wer die Prüfung als Teil eines vollständigen Website-Checks braucht, findet sie im SEO-Audit von taismo.
Lege für jede Seitenvorlage eine Referenz-URL fest, etwa einen Blogartikel, eine Leistungsseite und ein Produkt. Nach einem Update prüfst du nur diese drei Seiten und siehst sofort, ob sich das Markup aller Seiten dieses Typs verändert hat.
Wir bauen und prüfen strukturierte Daten für deine Website, vom Schema-Graphen bis zur Entität. Erzähl uns von deinem Projekt.
Häufige Fragen zum Prüfen strukturierter Daten
Wie prüfe ich, ob eine Seite strukturierte Daten hat?
Gib die URL in den Rich-Results-Test oder in den Schema Markup Validator ein. Schneller geht es mit einer Browser-Erweiterung oder mit der Suche nach „application/ld+json“ im Quelltext der Seite.
Was unterscheidet den Rich-Results-Test vom Schema Markup Validator?
Der Rich-Results-Test prüft, ob das Markup ein Rich Result in der Google-Suche auslösen kann. Der Schema Markup Validator prüft Syntax und das gesamte schema.org-Vokabular und gibt dabei keine Google-spezifischen Warnungen aus.
Warum zeigt Google kein Rich Result, obwohl der Test keine Fehler meldet?
Google garantiert keine Anzeige, auch bei gültigem Markup, und entscheidet je nach Suchanfrage, Gerät und Standort. Einige Darstellungen hat Google zudem eingeschränkt, etwa FAQ-Ergebnisse, die seit August 2023 nur noch für bekannte Behörden- und Gesundheitswebsites erscheinen.
Lesen KI-Systeme strukturierte Daten?
Für die KI-Funktionen der Google-Suche gelten dieselben Regeln wie für die Suche insgesamt, und Google verlangt, dass strukturierte Daten mit dem sichtbaren Text übereinstimmen. Wie stark andere KI-Systeme JSON-LD auswerten, legen die Anbieter nicht offen; zuverlässig erreichbar ist es für ihre Crawler, wenn es ohne JavaScript im ausgelieferten HTML steht.
Wie oft sollte ich strukturierte Daten prüfen?
Prüf strukturierte Daten nach jeder Änderung an Theme, SEO-Plugin oder Seitenvorlage. Die Berichte der Search Console solltest du zusätzlich einmal im Monat ansehen.
Quellen
- Google Search Central: „Testtool für Schema-Markup“, Google, abgerufen am 07.10.2026.
- Google Search Console-Hilfe: „Test für Rich-Suchergebnisse“, Google, abgerufen am 07.10.2026.
- Ryan Levering, Google Search Central Blog: „Test your structured data with the Rich Results Test and Schema Markup Validator“, Google, 15.12.2020, Updates vom 11.05. und 09.08.2021.
- Google Search Central: „Allgemeine Richtlinien für strukturierte Daten“, Google, abgerufen am 07.10.2026.
- Google Search Central Blog: „Änderungen bei Rich-Suchergebnissen zu Anleitungen und FAQs“, Google, 08.08.2023, Update vom 14.09.2023.
- Henry Hsu, Google Search Central Blog: „Vereinfachung der Suchergebnisseite“, Google, 12.06.2025.
- Google Search Console-Hilfe: „Statusberichte zu Rich-Suchergebnissen“, Google, abgerufen am 07.10.2026.
- Google Search Console-Hilfe: „URL-Prüftool“, Google, abgerufen am 07.10.2026.
- Google Search Central: „KI-Funktionen und deine Website“, Google, abgerufen am 07.10.2026.
- Google Search Central: „Strukturierte Daten mit JavaScript generieren“, Google, abgerufen am 07.10.2026.
- Giacomo Zecchini, Alice Alexandra Moore, Malte Ubl, Ryan Siddle: „The rise of the AI crawler“, Vercel, 17.12.2024.
- Schema.org: „Schemas (Version 30.1)“, schema.org, abgerufen am 07.10.2026.
- W3C: „JSON-LD 1.1: Node Identifiers“, World Wide Web Consortium, 16.07.2020.
- Chrome Web Store: „Rich Results: Structured Data Test Plugin“, Google, abgerufen am 07.10.2026.
- Chrome Web Store: „Fast Schema Markup Checker by Vryse SEO“, Google, abgerufen am 07.10.2026.
- Chrome Web Store: „SEO Schema Visualizer“, Google, abgerufen am 07.10.2026.
- Chrome Web Store: „Schema Builder for Structured Data“, Google, abgerufen am 07.10.2026.